










So funktioniert es
Schaffen Sie eine Grundlage vertrauenswürdiger Daten für Analysen und KI Agenten mit autonomer Überwachung KI -gesteuerte Fehlerbehebungen und ein für Agenten entwickelter Gesundheitskontext.
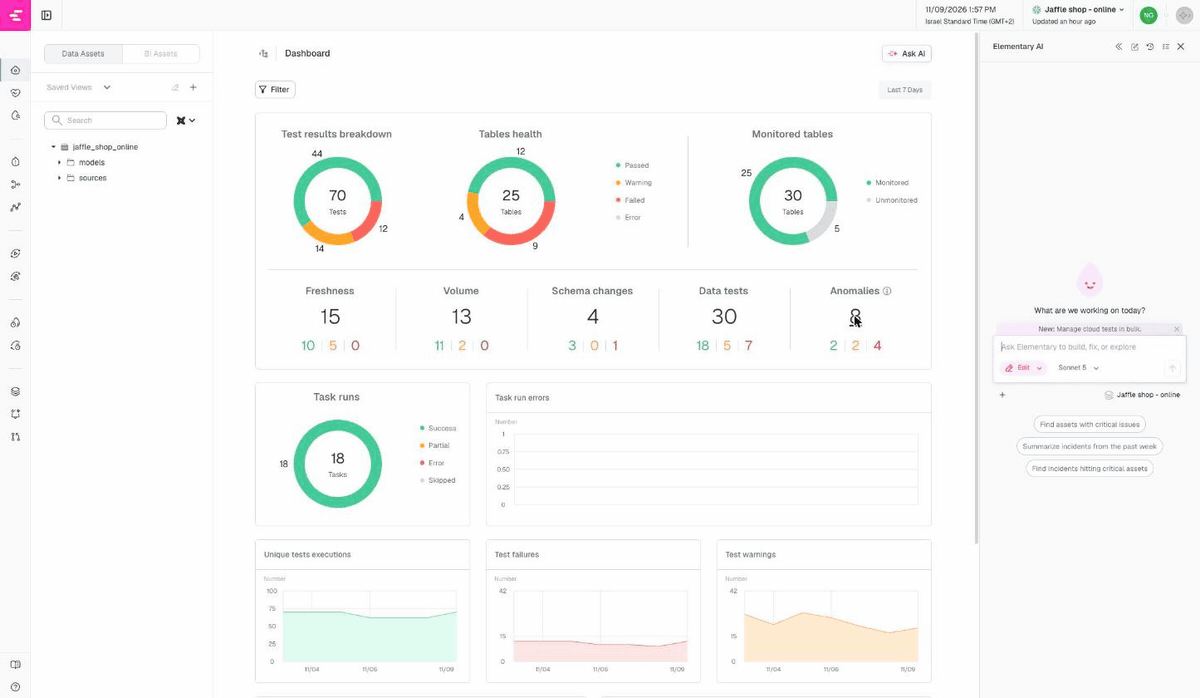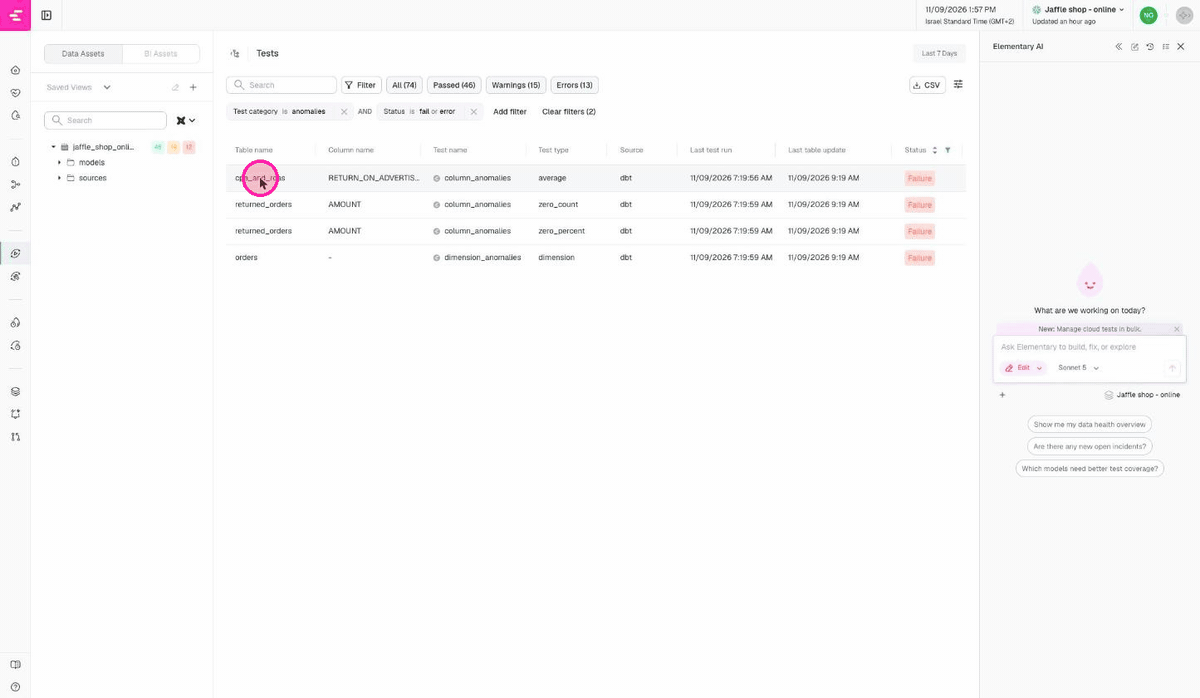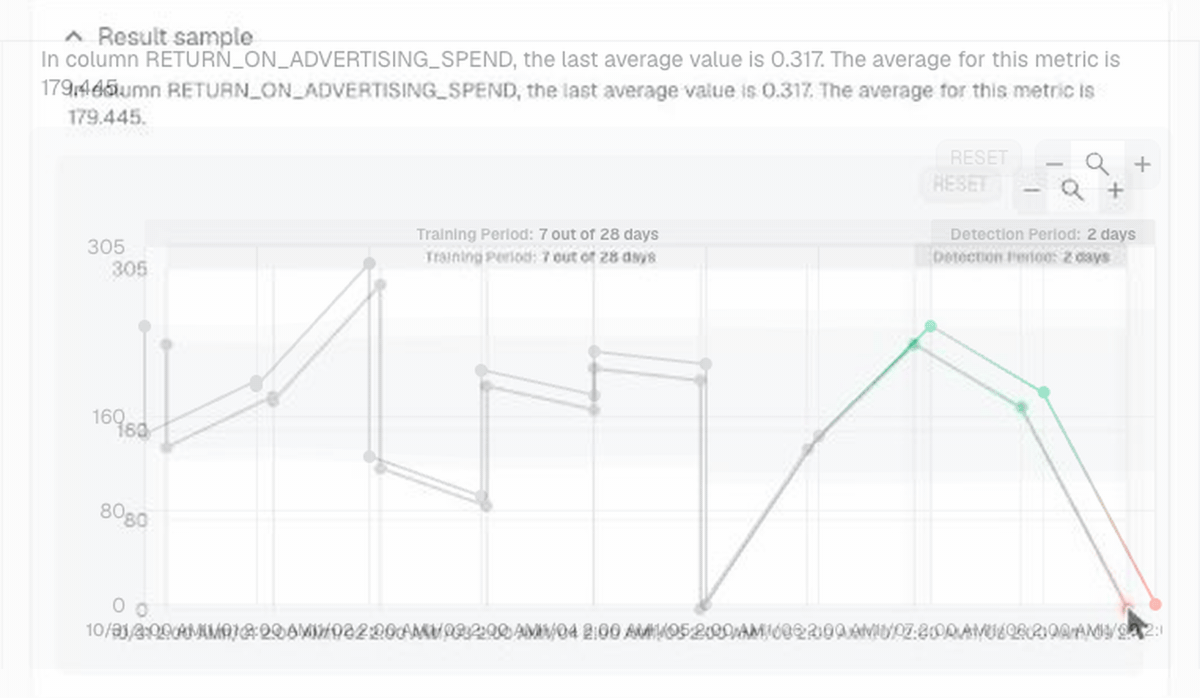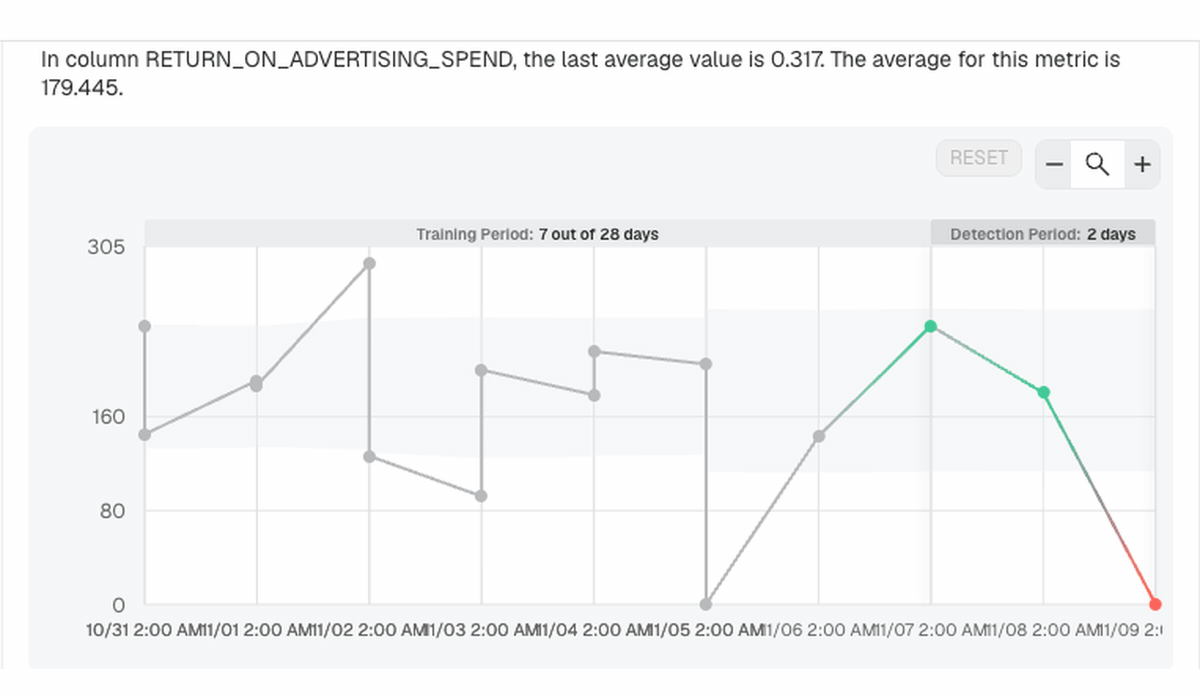
Autonome Überwachung der Datenqualität
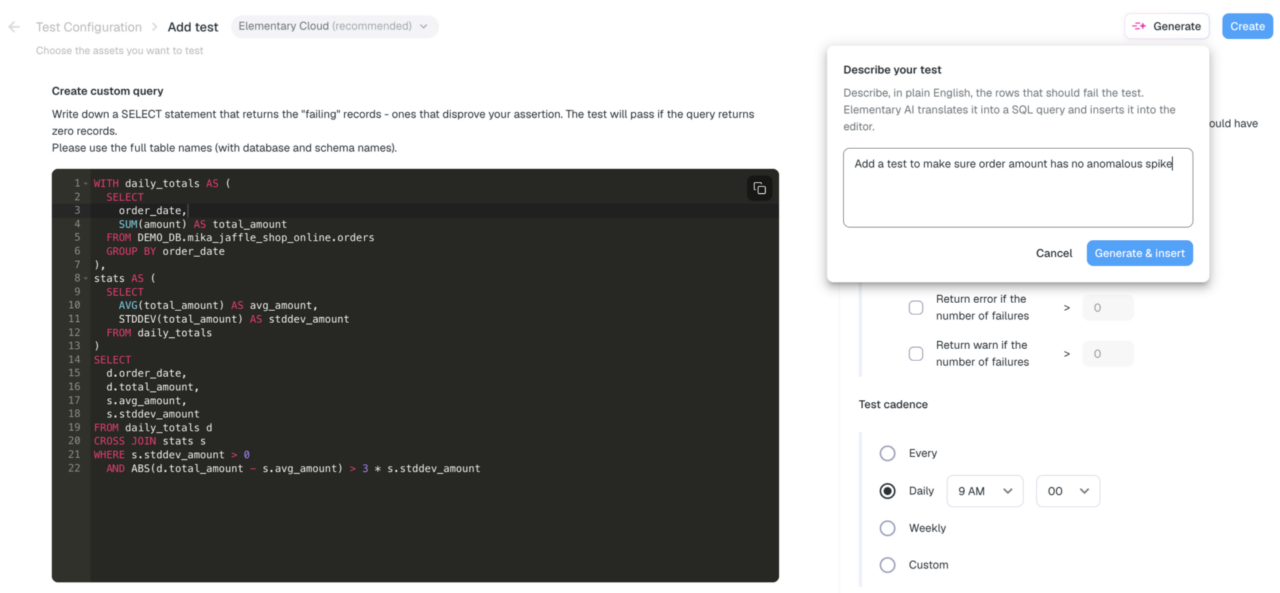
Erkennen Sie verspätete, fehlende und anomale Daten mit sofort einsatzbereiten ML-Monitoren und Qualitätssicherungsmechanismen, die fehlerhafte Änderungen verhindern, bevor diese Dashboards und Agenten erreichen. KI Die Agenten ermitteln Deckungslücken und empfehlen Tests, die Ihr Team genehmigen muss.
Datenprobleme schneller lösen
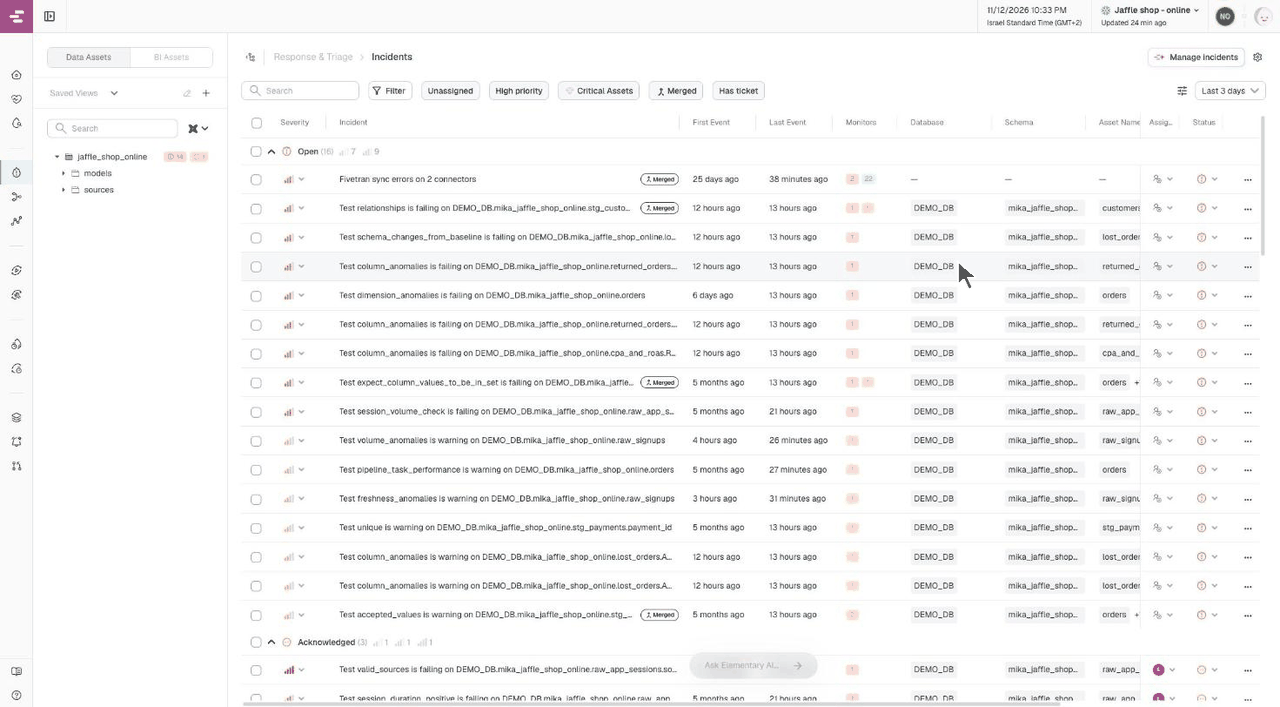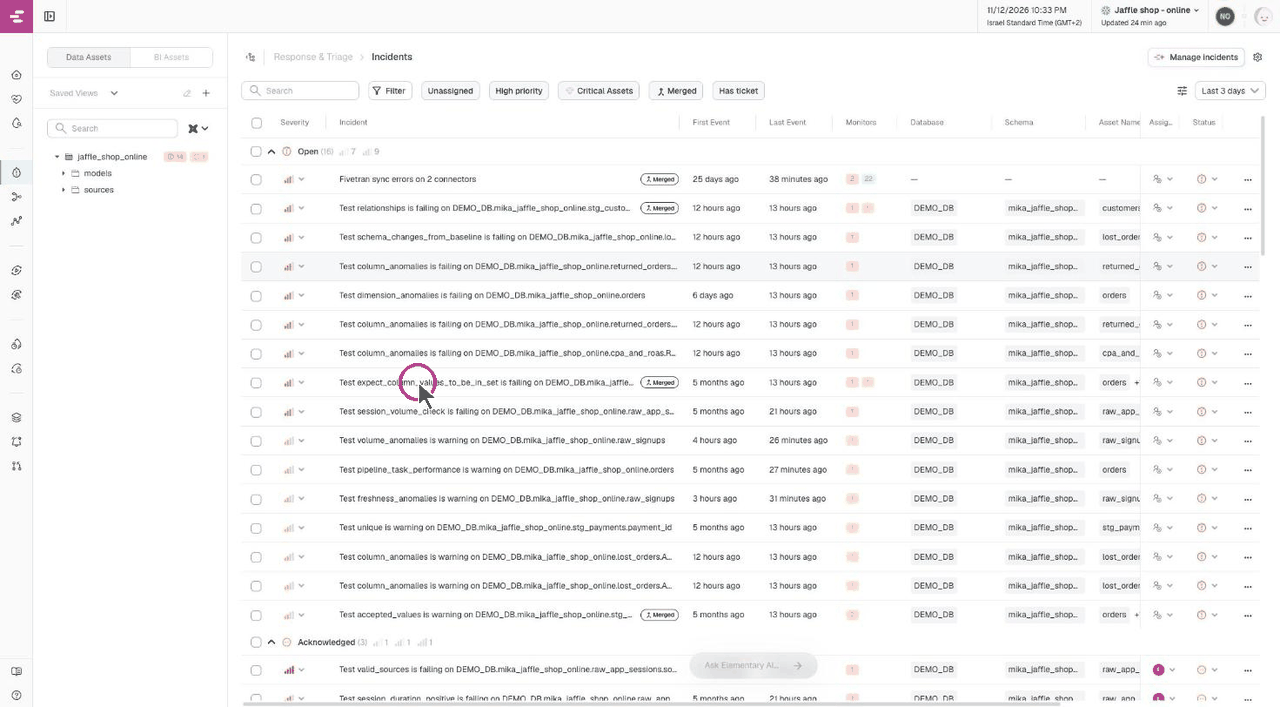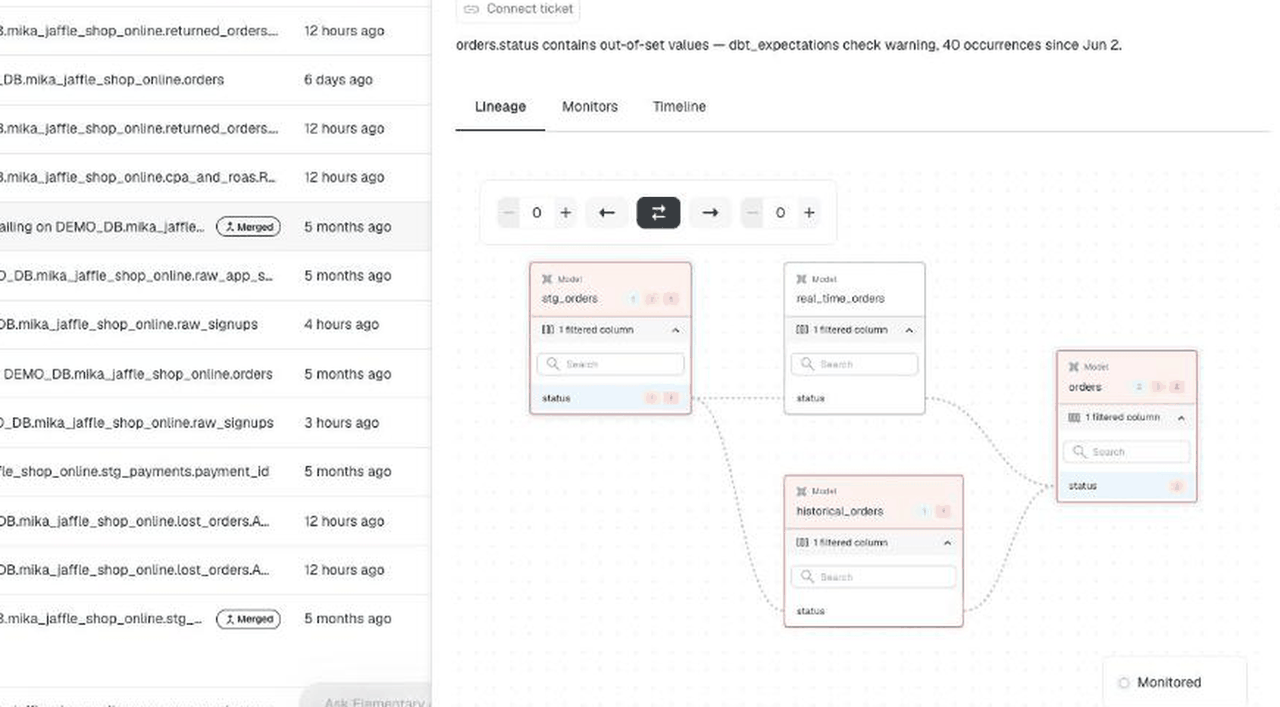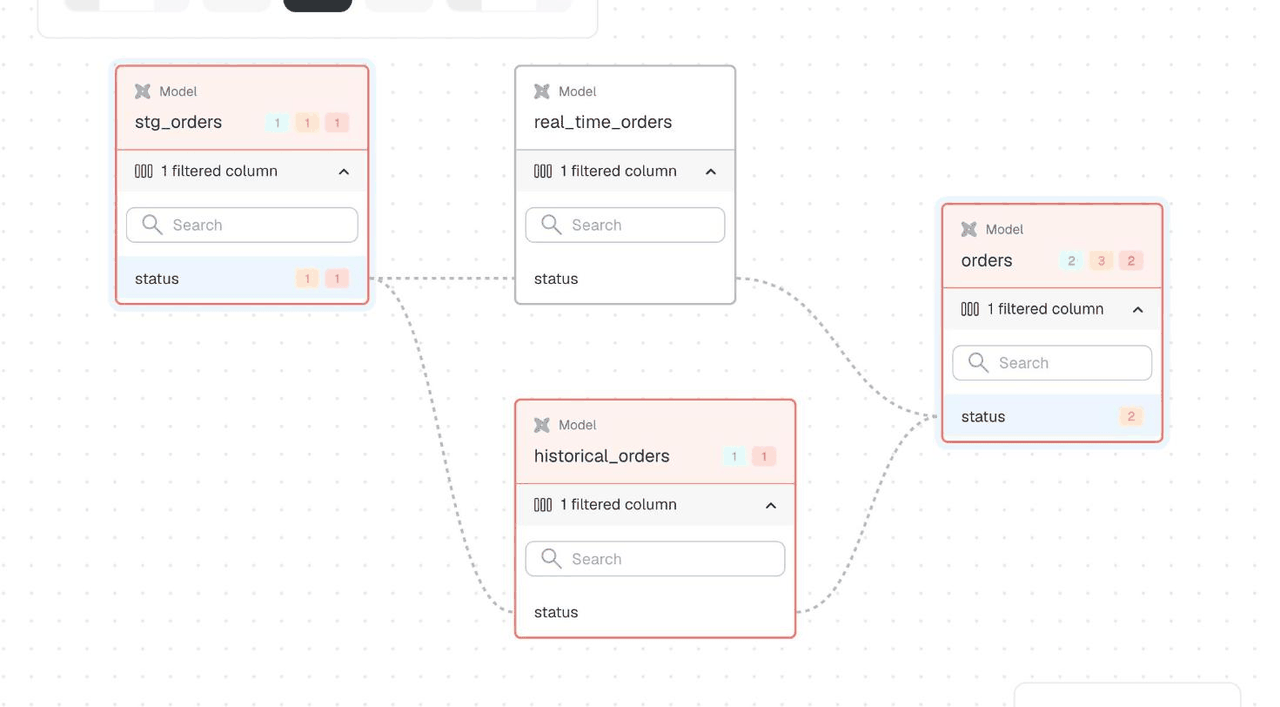
Zusammengehörige Fehler werden zu einem einzigen Vorfall mit einer einzigen Ursache zusammengefasst, der anhand der Spaltenhierarchie bis zur Quelle zurückverfolgt und an den zuständigen Verantwortlichen weitergeleitet wird. KI Untersuchen Sie die Situation, schlagen Sie eine Codekorrektur vor und erstellen Sie einen Pull Request zur Überprüfung durch Ihr Team.
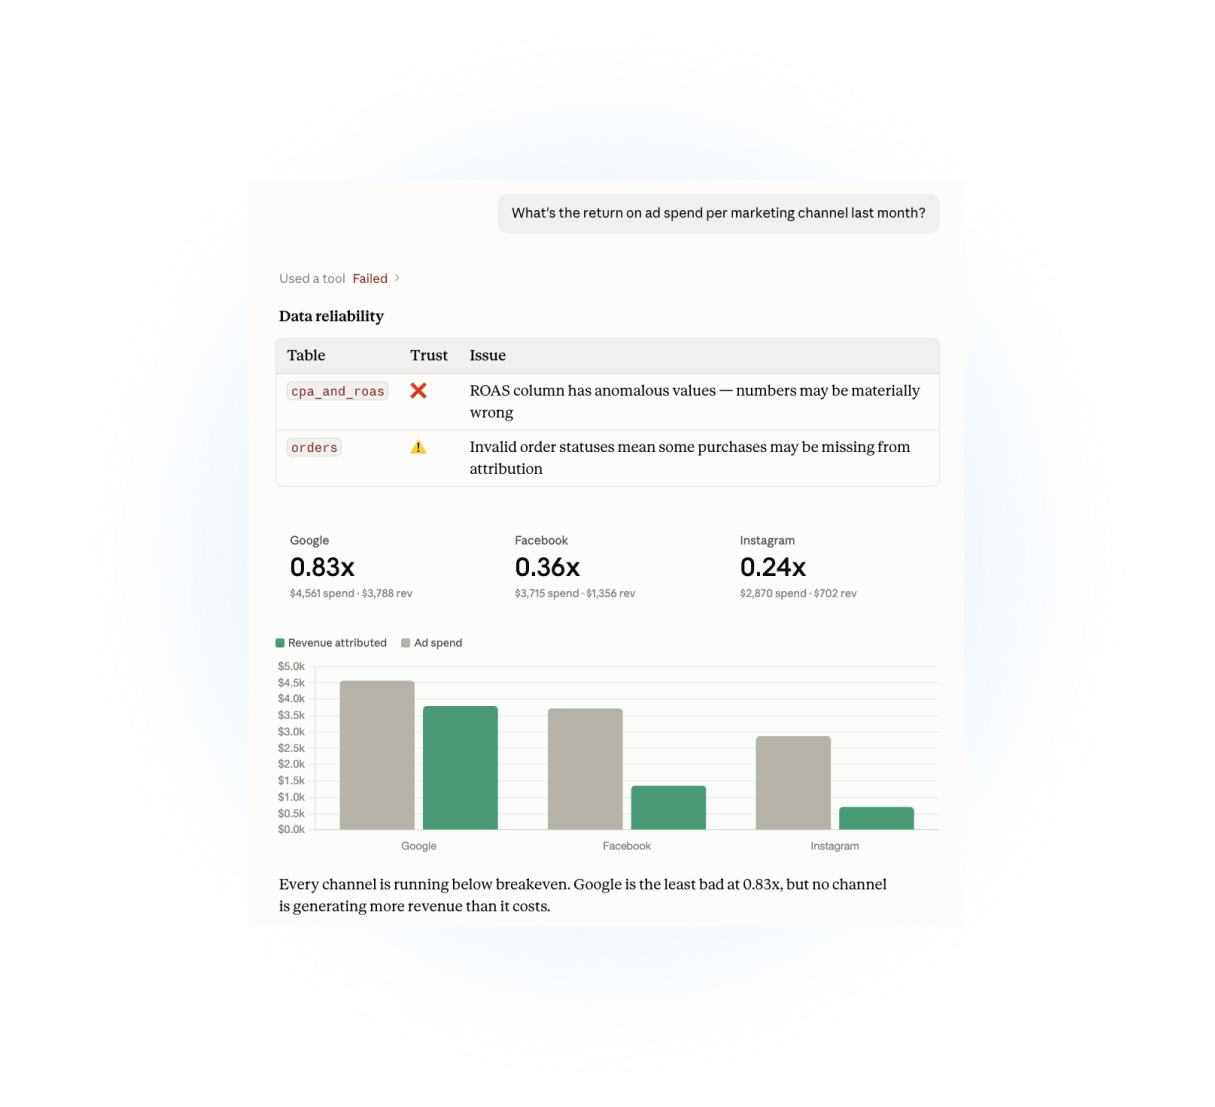
Weisen Sie Ihre Agenten darauf hin, welchen Daten sie vertrauen sollen.
Gib irgendein MCP Clients erhalten Live-Zugriff auf Herkunft, Tests und Vorfälle, sodass Agenten und deren Nutzer erkennen können, wann eine Antwort auf Daten mit bekannten Problemen basiert. Agenten werden mit vordefiniertem Kontext ausgeführt, anstatt diesen für jede Anfrage neu zu erstellen. Dadurch werden die Token-Kosten gesenkt.
Datenzuverlässigkeit für jedes Team demokratisieren
Data Engineers verwalten Tests als Code und behalten die Kontrolle über Änderungen und Genehmigungen. Business-Anwender fügen Validierungen ohne Code hinzu. Beide Gruppen haben Einblick in den Datenstatus und werden über Vorfälle benachrichtigt, die die von ihnen verwendeten Daten beeinträchtigen.
Elementare Datenmerkmale
Anomalieerkennung
Erkennen Sie verspätete, fehlende und anomale Daten mit sofort einsatzbereiten ML-Monitoren für Aktualität, Volumen und Spaltenmetriken.
KI Testabdeckung
Finden Sie ungetestete Assets und erhalten Sie auf Basis der Datennutzung empfohlene Tests zur Genehmigung durch Ihr Team.
In-Pipeline-Tests
Führen Sie Prüfungen innerhalb von dbt- und Python-Pipelines durch, damit Probleme erkannt werden, bevor die Daten weiterverarbeitet werden.
Quell- und BI-Integrationen
Verbinden Sie Data Warehouses, BI-Tools und Pipelines über Ihre gesamte Datenlandschaft hinweg, um einen einheitlichen Überblick über den Zustand Ihrer Daten zu erhalten.
Spaltenebene Herkunft
Verfolgen Sie die Spalten über alle Transformationen hinweg bis zur Ursache und allen betroffenen nachgelagerten Anlagen.
KI Triage und Lösung
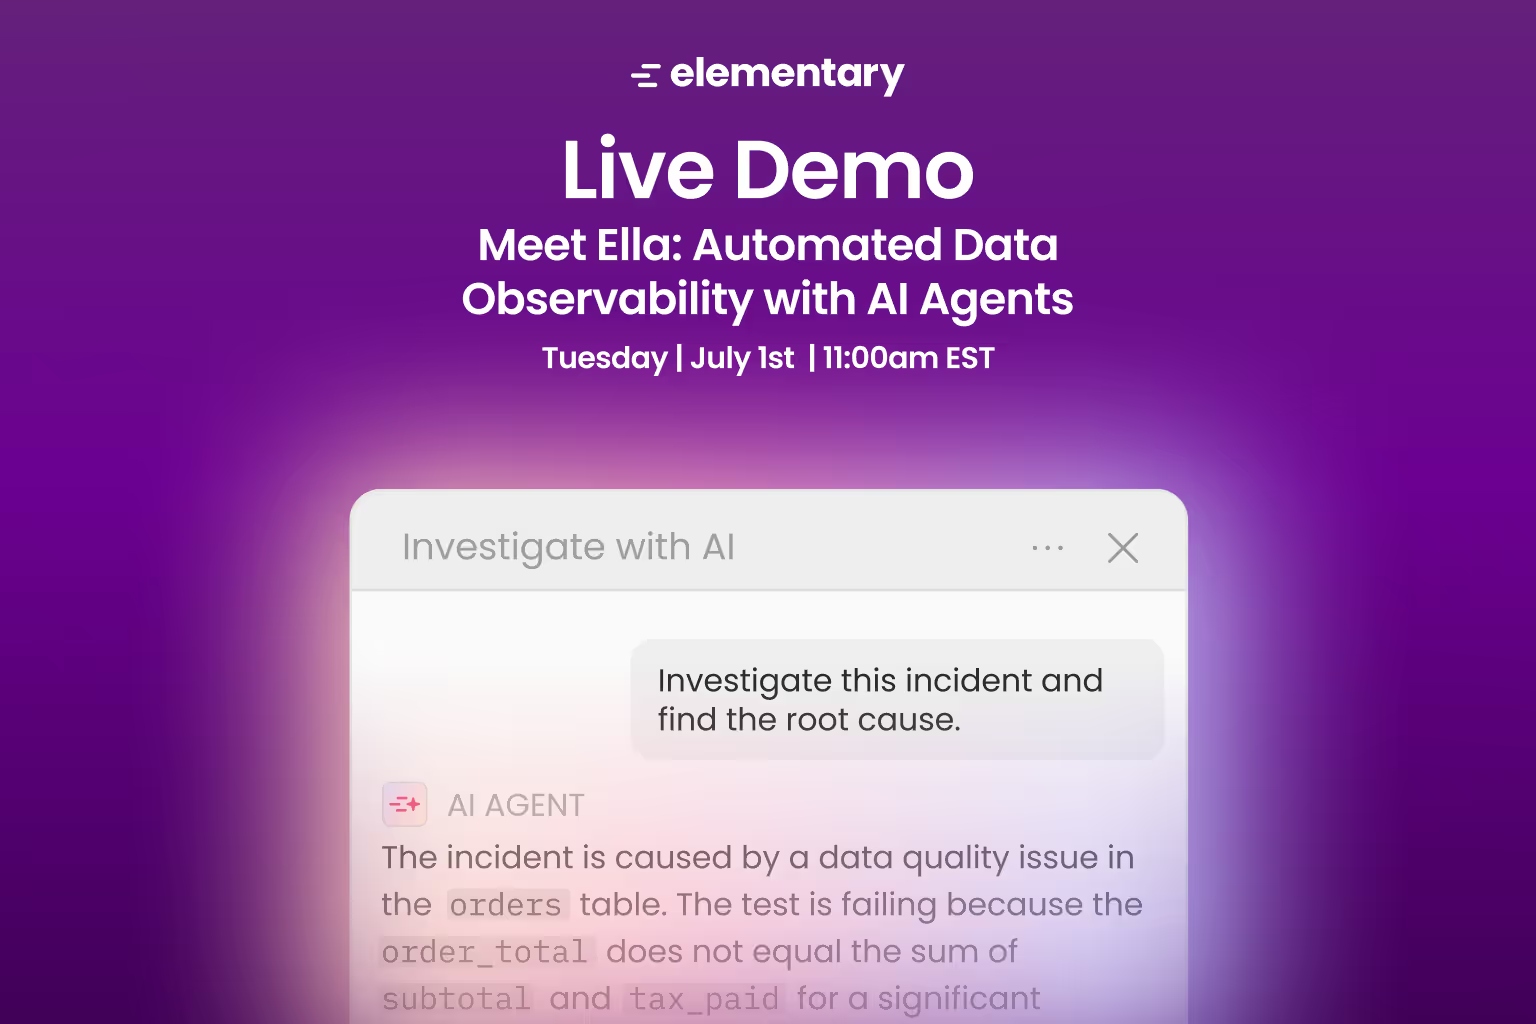
Untersuchen Sie selbstständig die Ursache, bewerten Sie die Auswirkungen und schlagen Sie eine Lösung als Pull-Anfrage zur Überprüfung durch Ihr Team vor.
Benachrichtigung und Ticketing
Eröffnen Sie für jedes Problem einen separaten Vorfall und leiten Sie ihn in Slack, PagerDuty und Jira an den zuständigen Verantwortlichen weiter.
MCP Server
Lass es einfach MCP Client-Abfragehistorie, Assets und offene Incidents, bereitgestellt durch denselben Agentenkontext und dasselbe Harness.
Daten-Gesundheitsbewertungen
Messen Sie die Datenqualität nach Domäne, Team und Asset. Die Datenqualitätsanalyse zeigt, wo Korrekturen priorisiert werden sollten.
Was unsere Kunden sagen

Elementare Datenressourcen
Häufig gestellte Fragen
Data Observability überwacht den Zustand Ihrer Daten und Pipelines. Sie erkennt veraltete, fehlende oder anomale Daten und hilft Teams, die Ursache zu finden und zu beheben, bevor nachgelagerte Nutzer beeinträchtigt werden.
Es nutzt maschinelles Lernen, um unerwartete Änderungen zu erkennen, beispielsweise einen Rückgang der Zeilenanzahl oder eine Tabelle, die nicht mehr aktualisiert wird. Elementary Data lernt, wie der Normalzustand für jedes Asset aussieht, und kennzeichnet Abweichungen frühzeitig.
Ja. Geschäftsanwender können Tests ohne Code erstellen, Integritätswerte verfolgen und Benachrichtigungen erhalten, während Entwickler Änderungen über Pull Requests überprüfen.
Die Kernüberwachung arbeitet mit Metadaten, Protokollen und Testergebnissen, ohne Zugriff auf Rohdaten. Für detailliertere Prüfungen und KI Untersuchungen, Elementary Runtime führt unterstützte Aufgaben innerhalb Ihrer Umgebung aus.
Elementary Data verwendet einen proprietären Agentenkontext und ein speziell für Herkunft und Metadaten entwickeltes Framework. Agenten beginnen mit dem benötigten Kontext, anstatt ihn von Grund auf neu zu erstellen, wodurch sie weniger Tokens benötigen als ein benutzerdefiniertes Kontextmodell auf generischen Frontier-Modellen.
Elementary Data legt Herkunft, Tests, Vorfälle und Gesundheitsbewertungen jedem offen. KI Werkzeug durch MCP Vor dem Handeln kann ein Agent prüfen, ob die Daten in Ordnung sind, wem sie gehören und welche Auswirkungen sie haben.
Elementary kombiniert ML-basierte Anomalieerkennung für Aktualität und Volumen mit Prüfungen, die in Ihren Pipelines ausgeführt werden, wie z. B. dbt- oder Python-Tests. KI Die Agenten identifizieren Lücken und erweitern den Versicherungsschutz basierend darauf, wie Ihre Daten genutzt werden.
dbt ist optional. Wenn Sie es verwenden, integriert sich Elementary nativ über sein Open-Source-Paket dbt, und Änderungen an der Benutzeroberfläche werden mit dem Code synchronisiert.
Elementary Data integriert sich nativ in dbt Core und dbt Cloud und verbindet sich mit Data Warehouses wie z. B. Snowflake und Databricks und erweitert die Datenherkunft auf Spaltenebene auf BI-Tools wie Sigma und Looker. Es öffnet Pull-Anfragen in GitHub und leitet Benachrichtigungen an Slack, Jira und weitere Dienste weiter.
Zusammengehörige Fehler werden zu einem Vorfall mit einer einzigen Benachrichtigung zusammengefasst, die nur an die Eigentümer oder Abonnenten der betroffenen Assets gesendet wird. Vorfälle werden automatisch behoben, sobald die Tests erfolgreich abgeschlossen sind.
Die Agenten sind optional und laufen auf selbstgehosteten Systemen, sodass keine Daten mit externen Diensten geteilt werden. Jede Änderung wird per Pull-Request von Ihrem Team freigegeben.