










Come funziona
Crea una base di dati affidabili per l’analisi e gli agenti “ AI ”, grazie al monitoraggio autonomo, alle correzioni basate sull’ AI e e al contesto di integrità progettato appositamente per gli agenti.
Monitorare la qualità dei dati in modo autonomo
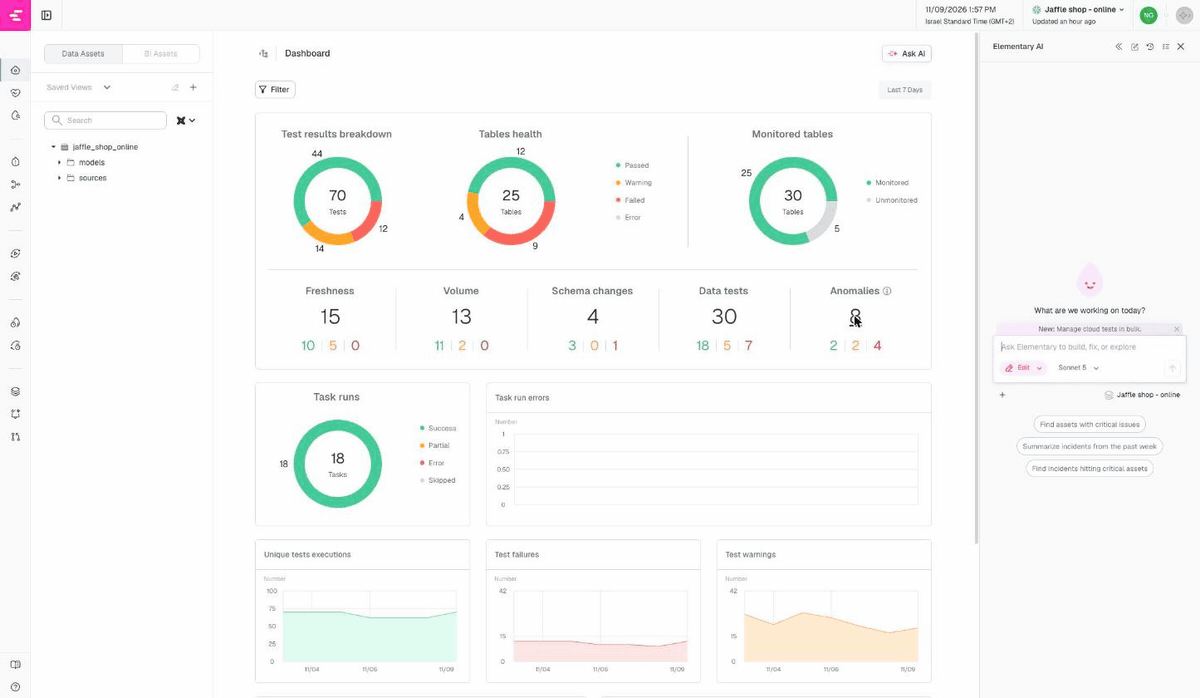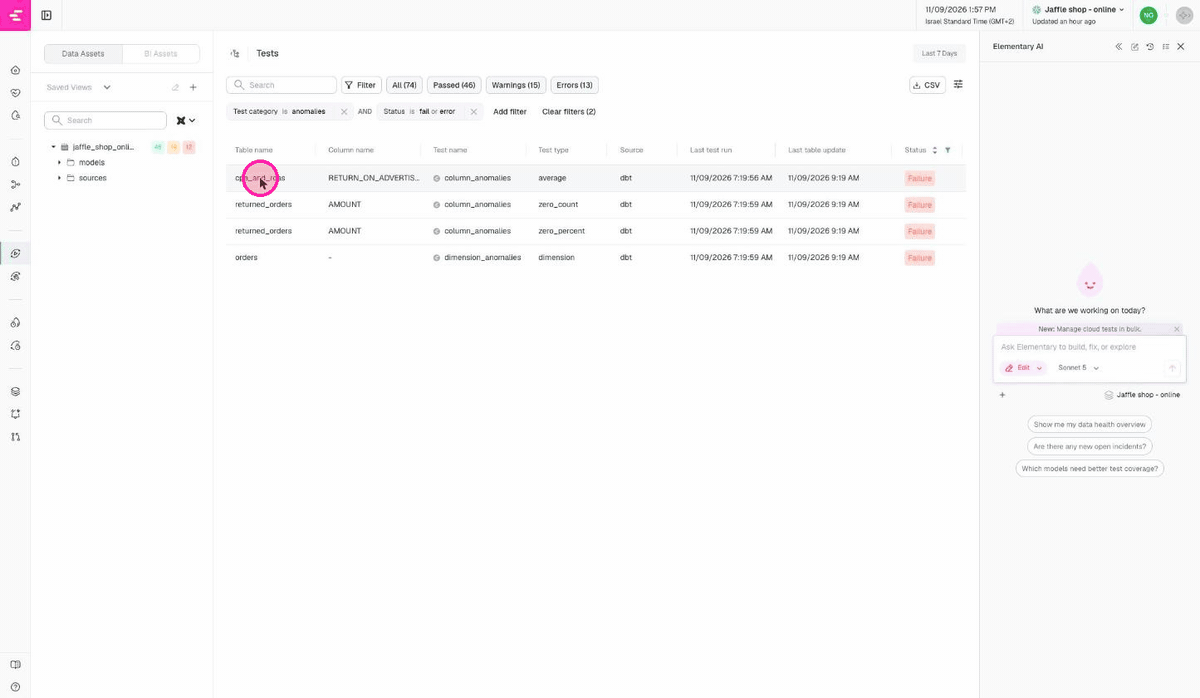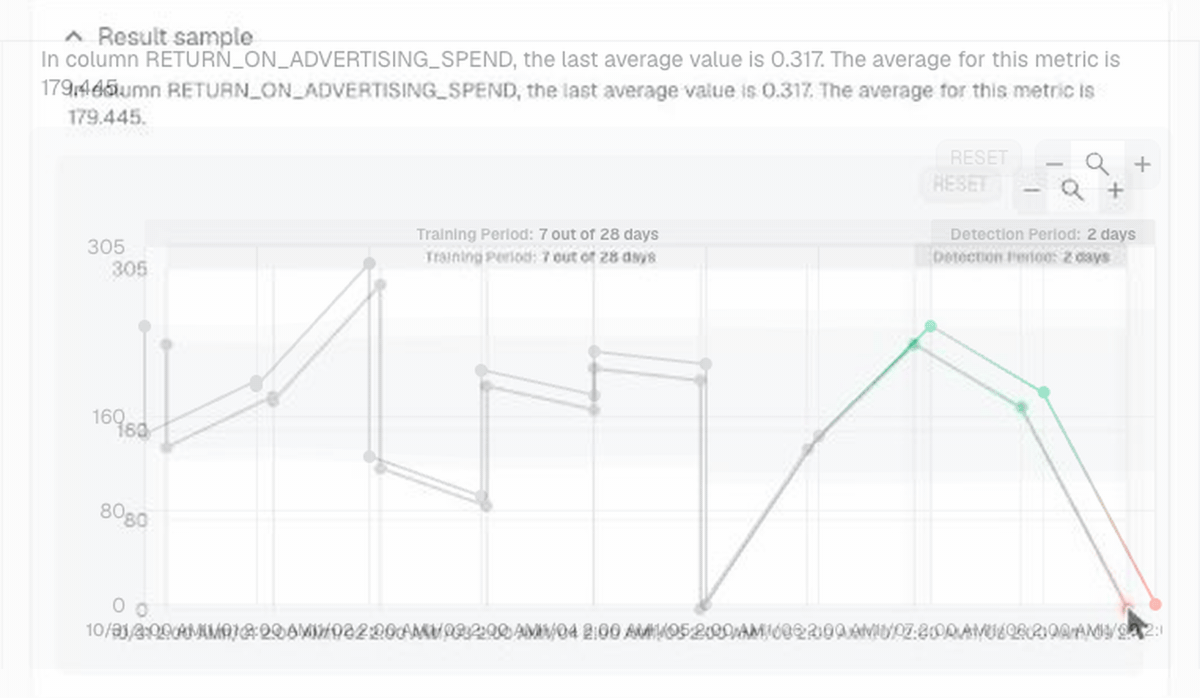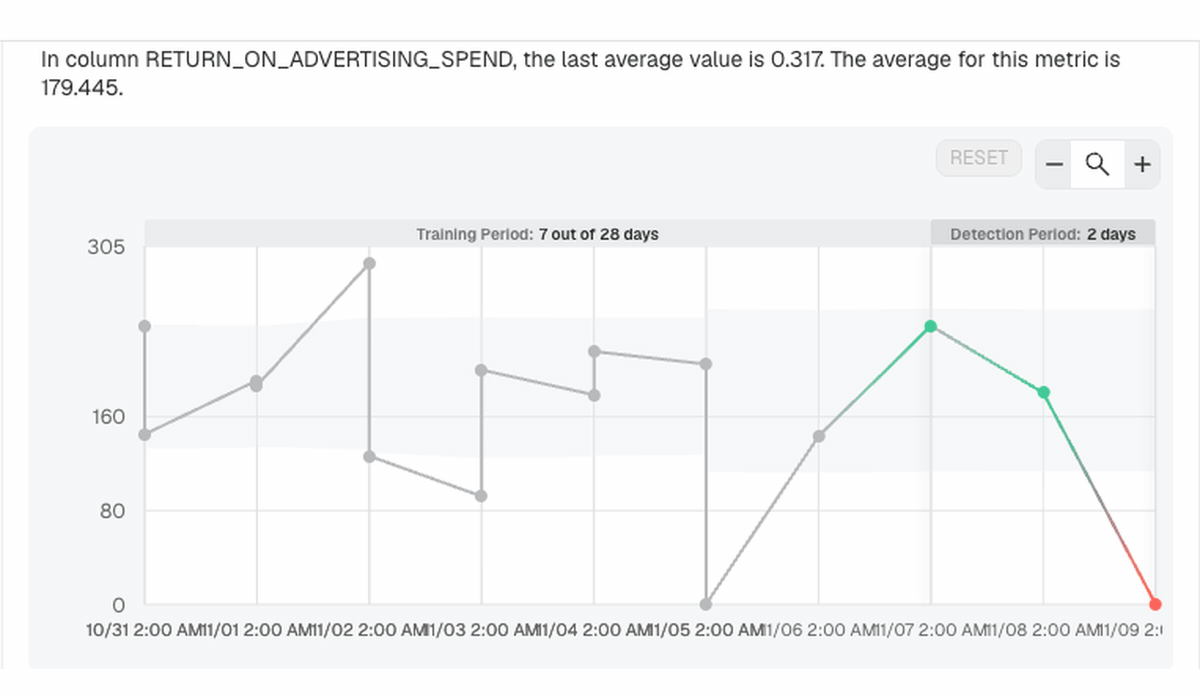
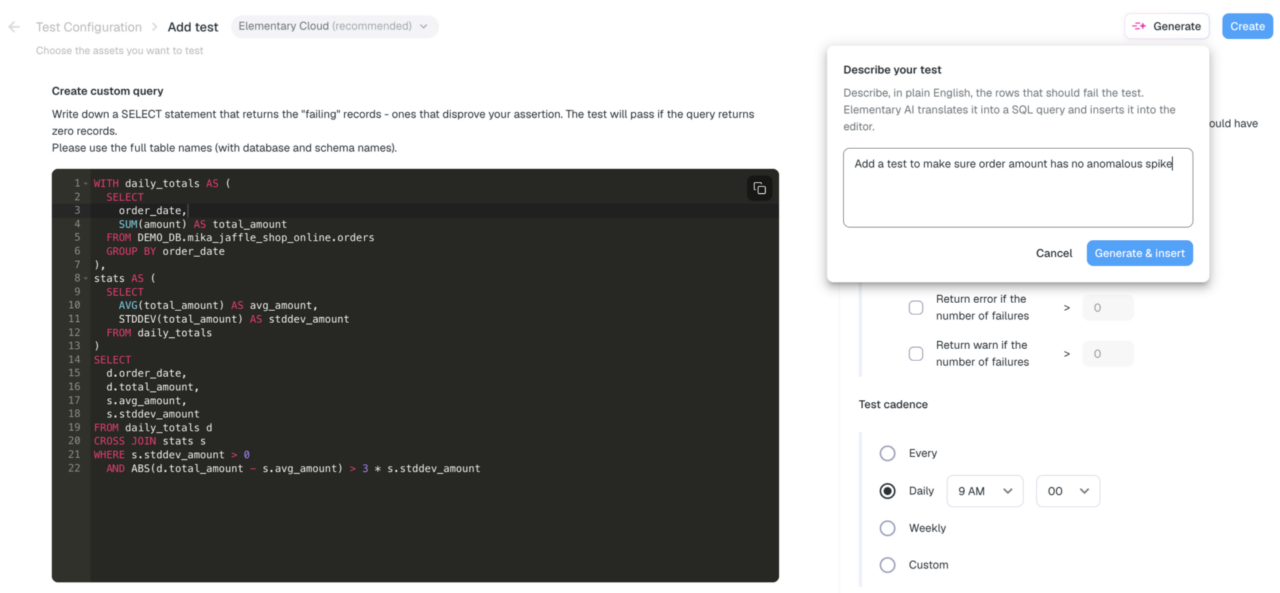
Individua i dati in ritardo, mancanti e anomali grazie ai monitor ML pronti all’uso, oltre ai controlli di qualità che bloccano le modifiche che potrebbero causare malfunzionamenti prima che raggiungano le dashboard e gli agenti. Lascia che gli agenti di AI individuino le lacune nella copertura e suggeriscano dei test che il tuo team potrà approvare.
Risolvere più rapidamente i problemi relativi ai dati
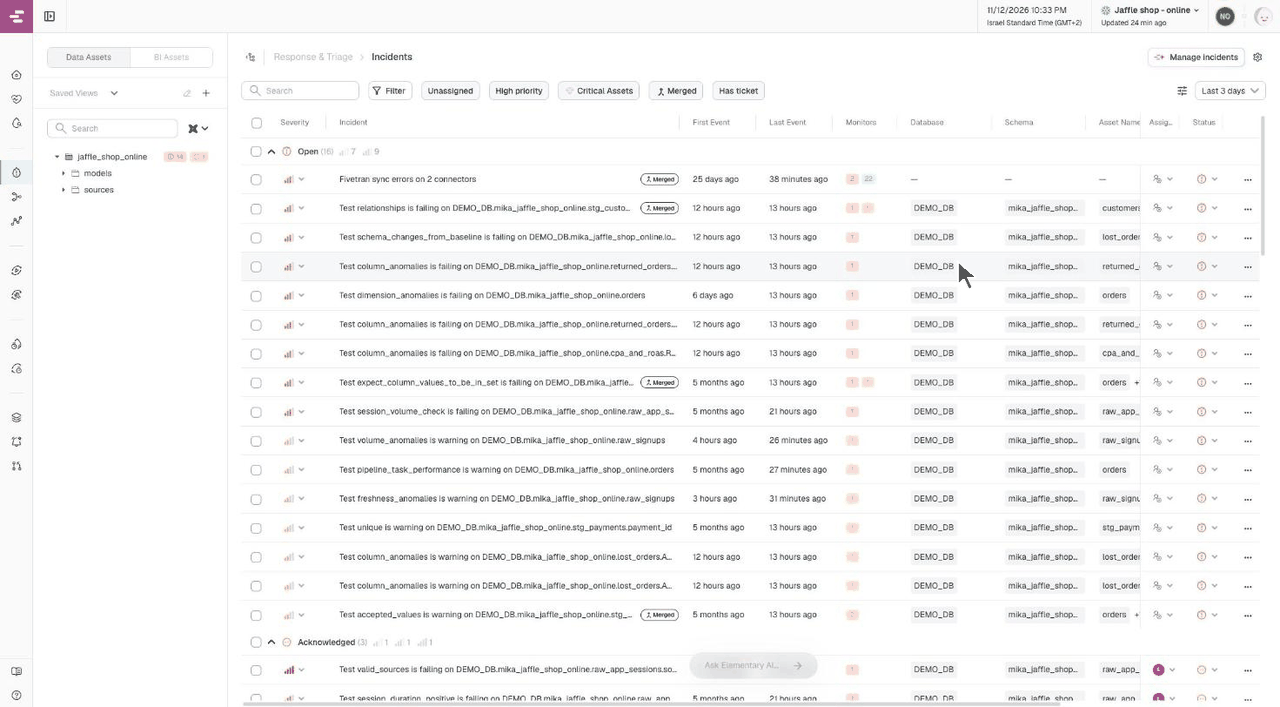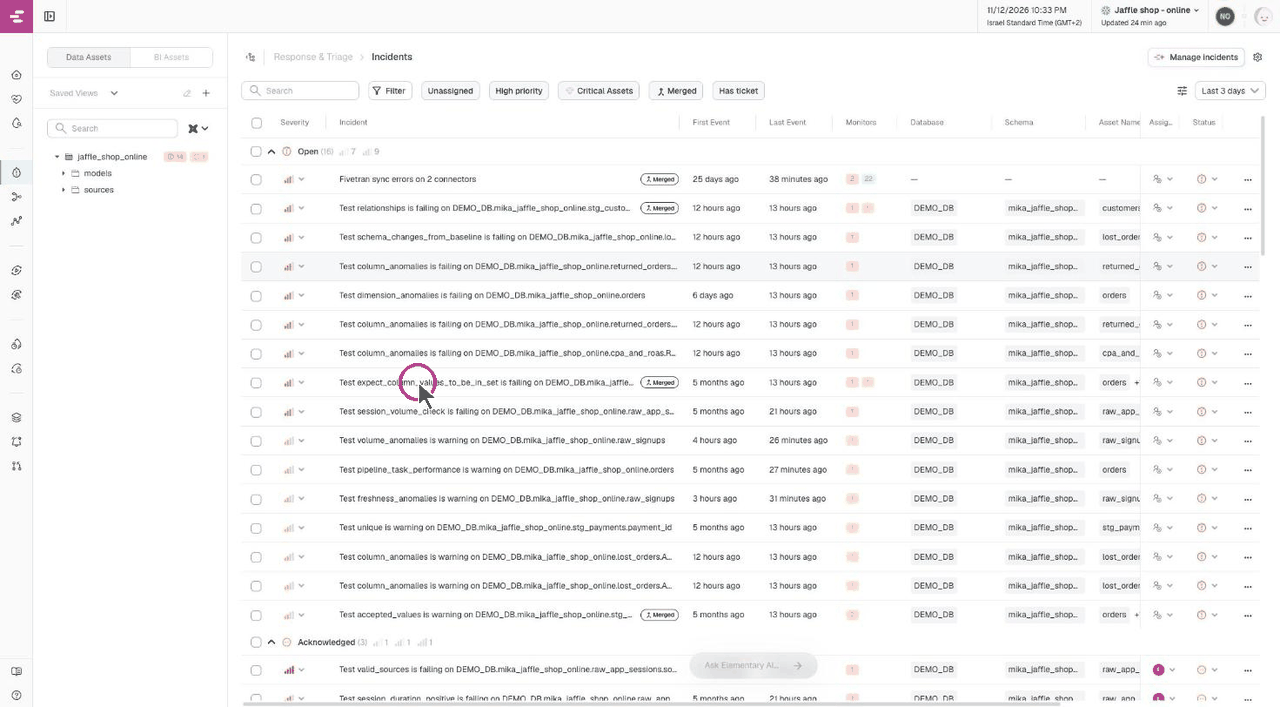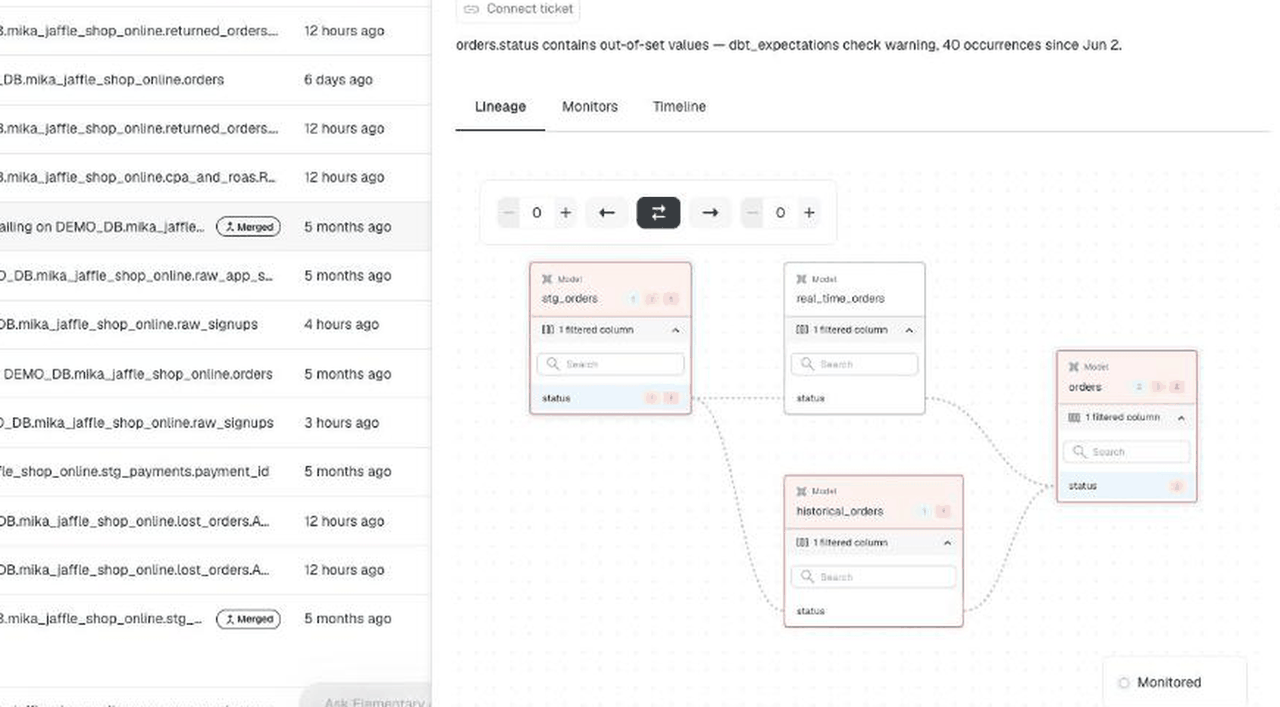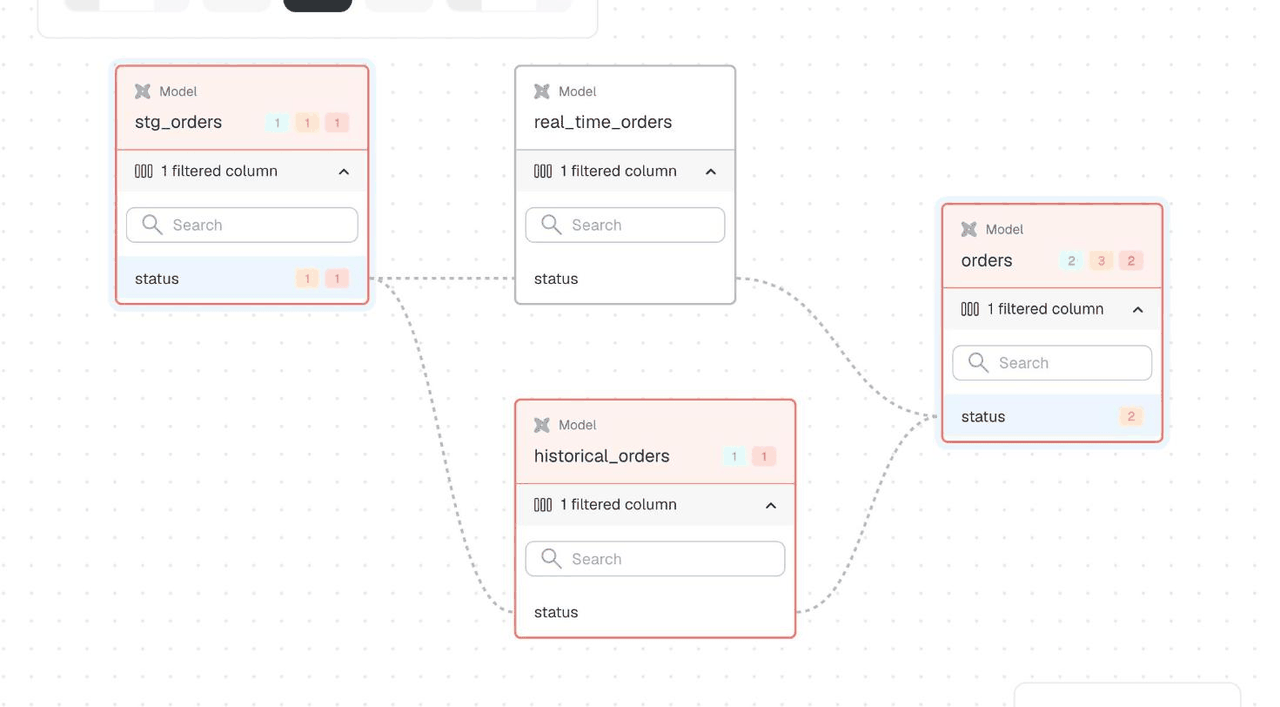
Raggruppa i guasti correlati in un unico incidente con un'unica causa principale, rintracciala alla fonte grazie alla tracciabilità a livello di colonna e indirizzala al responsabile competente. Lascia che AI conduca un'indagine, proponga una correzione del codice e apra una pull request affinché il tuo team possa esaminarla.
Indicare agli agenti quali dati considerare attendibili
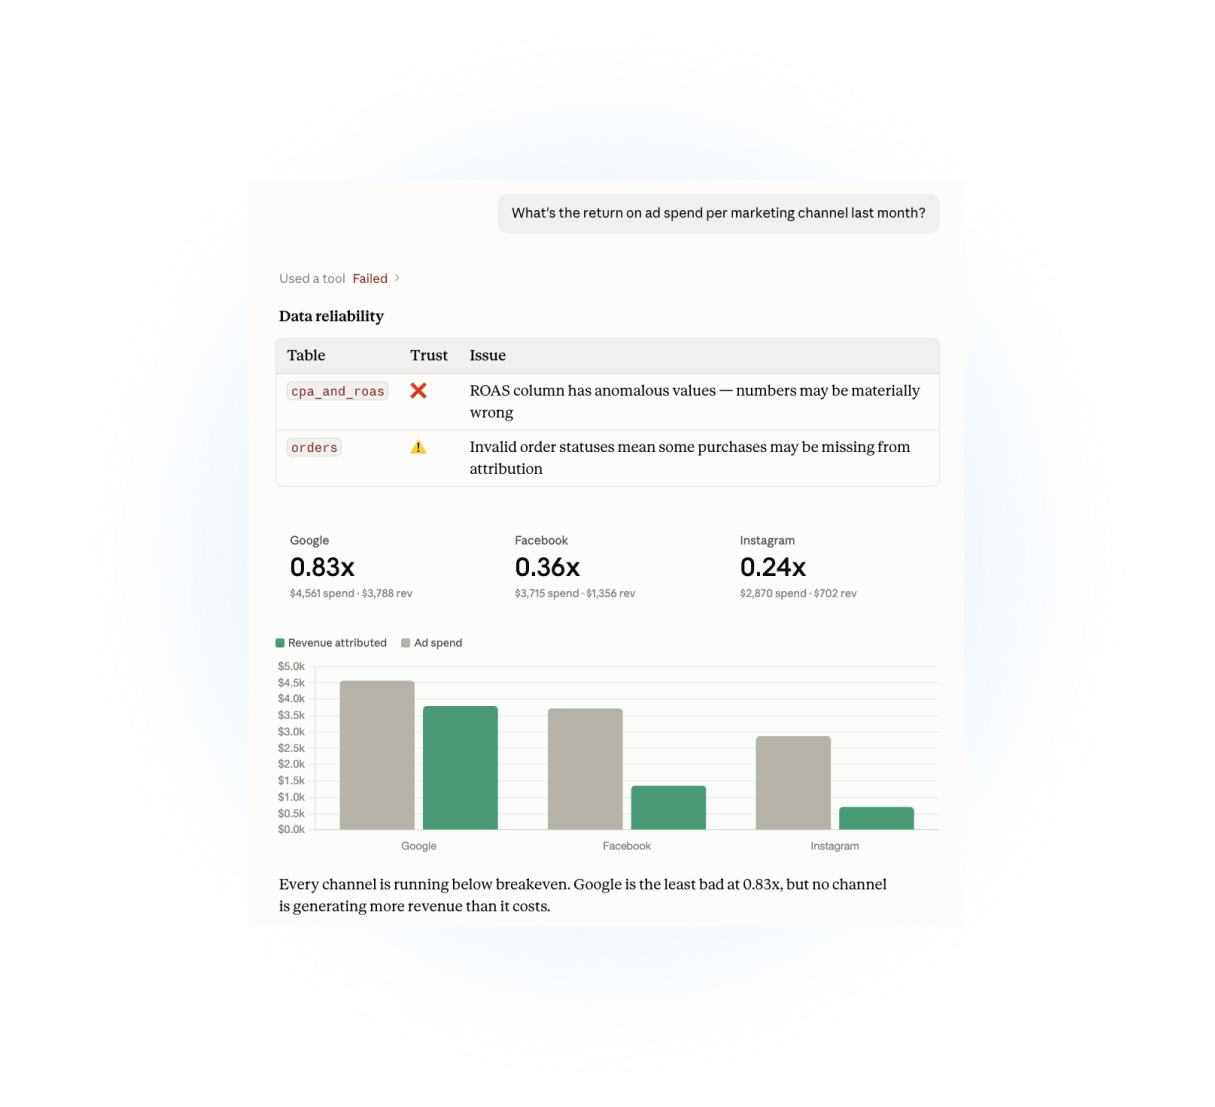
Concedi a qualsiasi client MCP l'accesso in tempo reale alla tracciabilità, ai test e agli incidenti, in modo che gli agenti e gli utenti possano rendersi conto quando una risposta si basa su dati con problemi noti. Esegui gli agenti su un contesto predefinito anziché ricostruirlo per ogni richiesta, riducendo così il costo dei token.
Rendere accessibile a tutti i team l'affidabilità dei dati
I data engineer gestiscono i test come codice e mantengono il controllo sulle modifiche e sulle approvazioni. Gli utenti aziendali aggiungono validazioni senza scrivere codice. Entrambi possono verificare lo stato dei dati e ricevono avvisi in caso di incidenti che interessano i dati su cui fanno affidamento.
Caratteristiche dei dati elementari
Rilevamento delle anomalie
Individua i dati in ritardo, mancanti e anomali grazie ai monitor di ML per la freschezza, il volume e le metriche delle colonne, pronti all’uso.
AI Copertura dei test
Individua le risorse non testate e ottieni suggerimenti sui test da eseguire in base alle modalità di utilizzo dei tuoi dati, affinché il tuo team possa approvarli.
Test in fase di sviluppo
Esegui dei controlli all’interno delle pipeline dbt e Python, in modo che eventuali problemi vengano individuati prima che i dati vengano trasferiti.
Integrazioni con le fonti e con i sistemi di business intelligence
Collega magazzini dati, strumenti di BI e pipeline in tutto il tuo ecosistema di dati per ottenere una visione unica dello stato di integrità dei dati.
Lineaggio a livello di colonna
Tracciare le colonne attraverso le trasformazioni fino alla causa principale e a ogni risorsa a valle interessata.
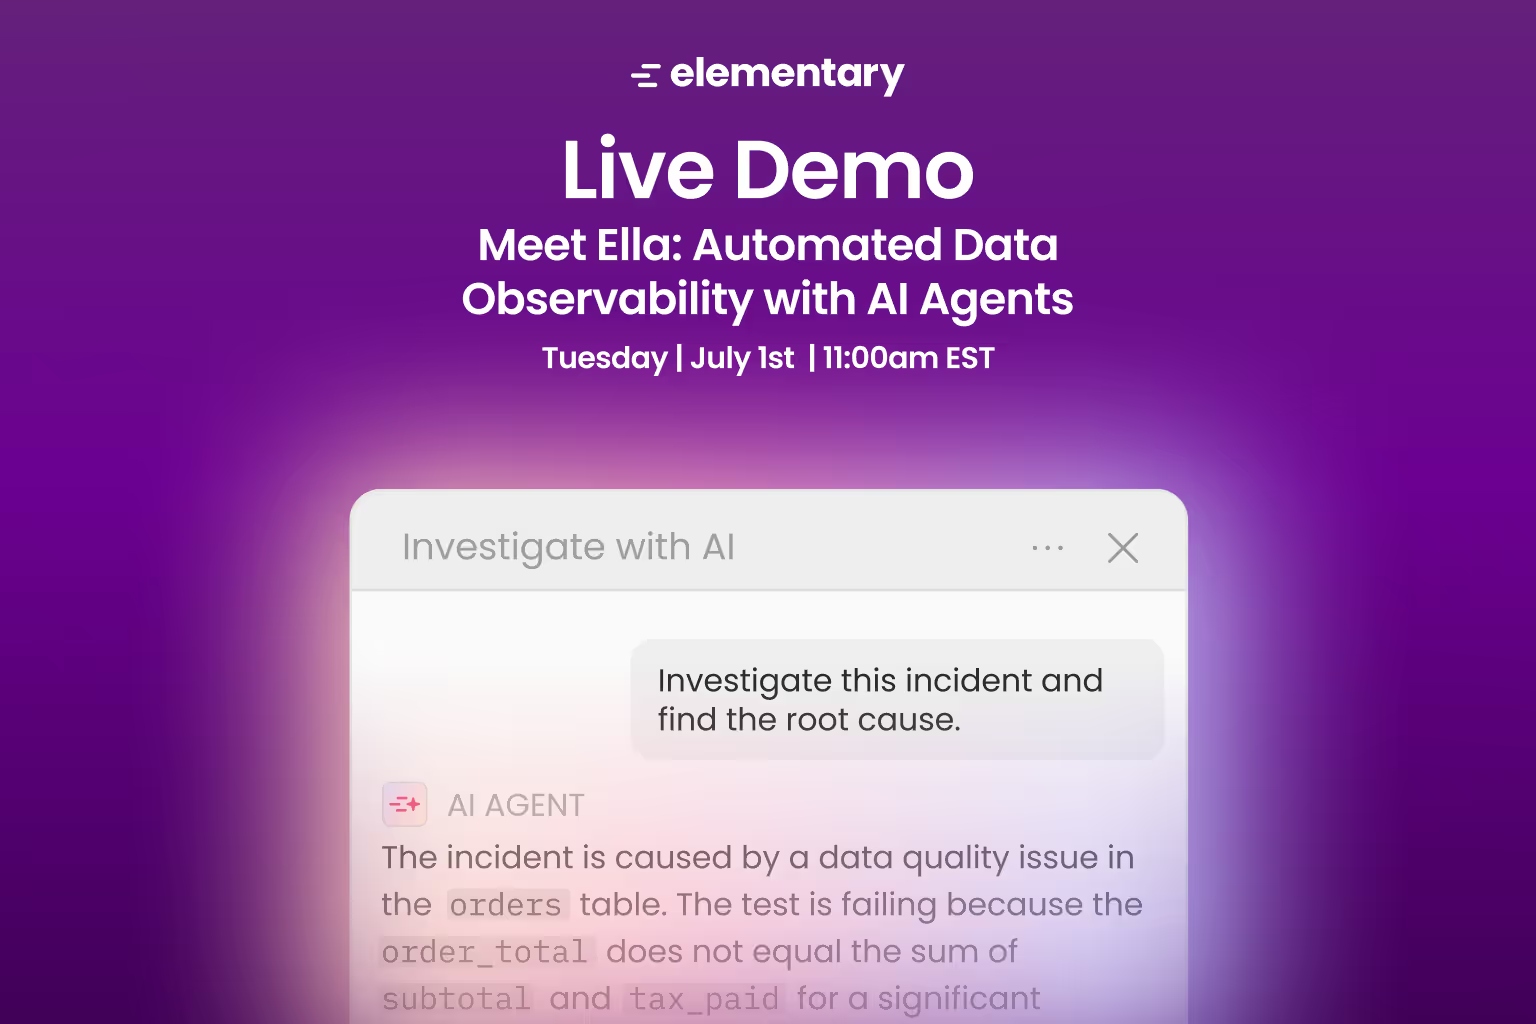
AI Valutazione e risoluzione
Indaga in modo autonomo sulla causa principale, valuta l'impatto e proponi una soluzione sotto forma di pull request affinché il tuo team possa esaminarla.
Segnalazioni e ticket
Apri un ticket per ogni problema e inoltralo al responsabile competente su Slack, PagerDuty e Jira.
MCP Server
Qualsiasi client MCP può interrogare la cronologia, le risorse e gli incidenti aperti, grazie allo stesso contesto e allo stesso framework dell'agente.
Punteggi relativi alla salute dei dati
Valuta lo stato dei dati per dominio, team e risorsa. L'analisi della qualità dei dati indica dove intervenire in via prioritaria.
Cosa dicono i nostri clienti

Risorse di dati elementari
Domande frequenti
L'osservabilità dei dati monitora lo stato di integrità dei dati e delle pipeline. Rileva dati obsoleti, mancanti o anomali e aiuta i team a individuarne la causa e a risolverla prima che gli utenti a valle ne subiscano le conseguenze.
Utilizza l'apprendimento automatico per individuare cambiamenti inaspettati, come un calo nel numero di righe o una tabella che smette di aggiornarsi. Elementary Data apprende quale sia il comportamento normale per ogni risorsa e segnala tempestivamente eventuali scostamenti.
Sì. Gli utenti aziendali possono creare test senza scrivere codice, monitorare i punteggi di integrità e ricevere avvisi, mentre gli ingegneri esaminano le modifiche tramite pull request.
Il monitoraggio di base si basa su metadati, log e risultati dei test, senza accedere ai dati grezzi. Per controlli più approfonditi e indagini di tipo “ AI ”, Elementary Runtime esegue le attività supportate all’interno del tuo ambiente.
Elementary Data utilizza un contesto e un harness proprietari per gli agenti, sviluppati appositamente per il lineage e i metadati. Gli agenti partono dal contesto di cui hanno bisogno, anziché costruirlo da zero, quindi utilizzano un numero inferiore di token rispetto a un modello di contesto personalizzato su modelli generici di tipo “frontier”.
Elementary Data rende disponibili informazioni sulla provenienza dei dati, i test, gli incidenti e i punteggi di integrità a qualsiasi strumento di " AI " tramite MCP. Prima di intervenire, un agente può verificare se i dati sono integri, chi ne è il proprietario e su cosa hanno un impatto.
Elementary combina il rilevamento delle anomalie basato sul machine learning (ML) per la freschezza e il volume dei dati con controlli eseguiti all’interno delle vostre pipeline, come i test dbt o Python. Gli agenti di AI identificano le lacune e ampliano la copertura in base alle modalità di utilizzo dei vostri dati.
dbt è facoltativo. Se lo si utilizza, Elementary si integra in modo nativo tramite il proprio pacchetto dbt open source e le modifiche apportate nell'interfaccia utente vengono sincronizzate con il codice.
Elementary Data si integra in modo nativo con dbt Core e dbt Cloud, si collega a data warehouse quali Snowflake e Databricks ed estende la tracciabilità a livello di colonna a strumenti di BI come Sigma e Looker. Crea pull request su GitHub e inoltra gli avvisi a Slack, Jira e altre piattaforme.
Gli errori correlati vengono raggruppati in un unico incidente con un unico avviso, inviato solo alle persone responsabili delle risorse interessate o che ne sono in carico. Gli incidenti si risolvono automaticamente quando i test vengono superati.
Gli agenti sono attivabili su richiesta e funzionano su modelli self-hosted, quindi non viene condiviso nulla con servizi esterni. Ogni modifica passa attraverso una pull request che il tuo team deve approvare.