










Comment ça marche ?
Constituez une base de données fiables pour l'analyse et les agents IA, grâce à une surveillance autonome, des corrections pilotées par l'IA et un contexte d'état de santé spécialement conçu pour les agents.
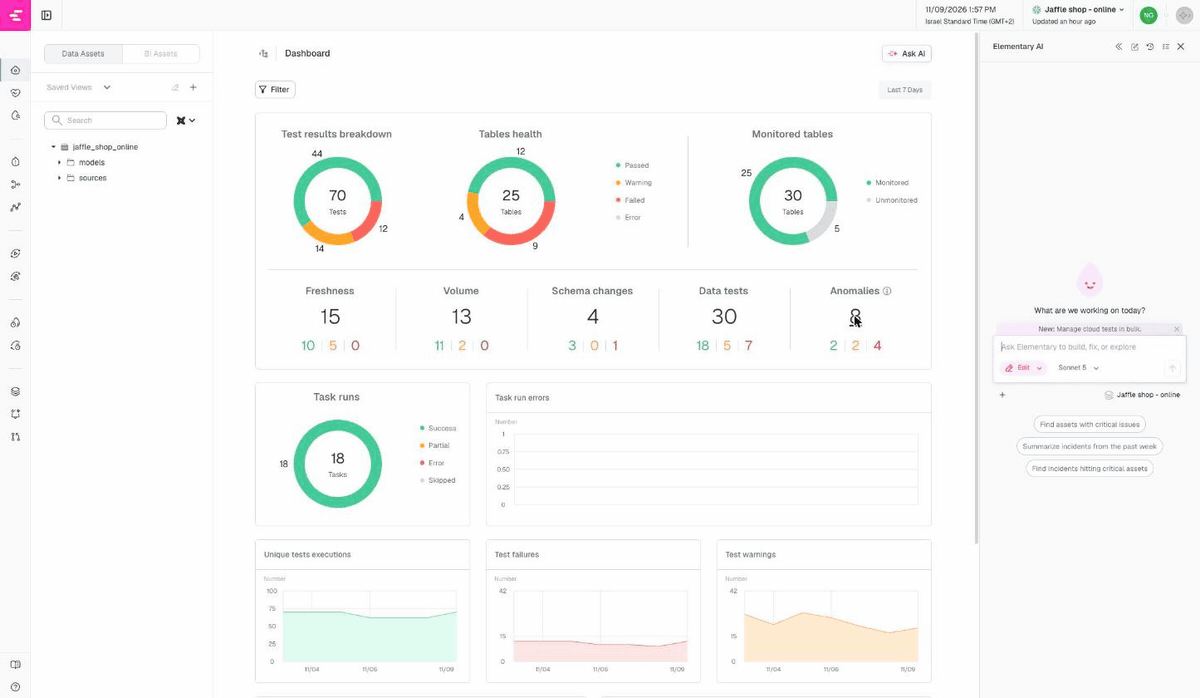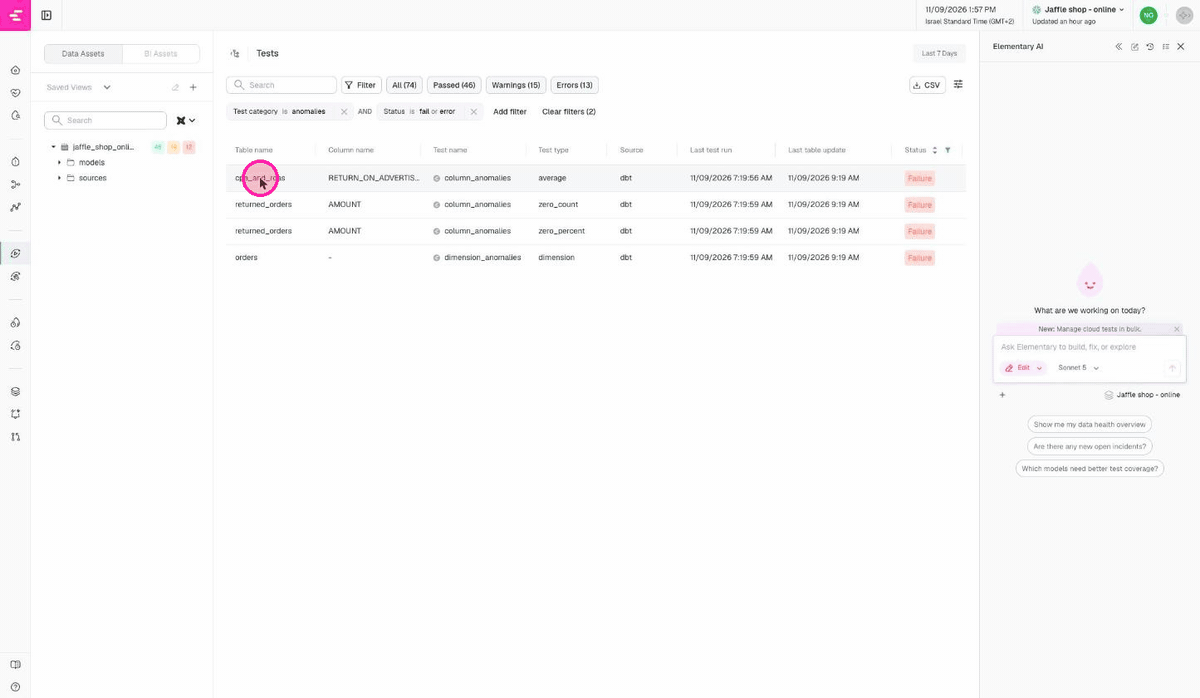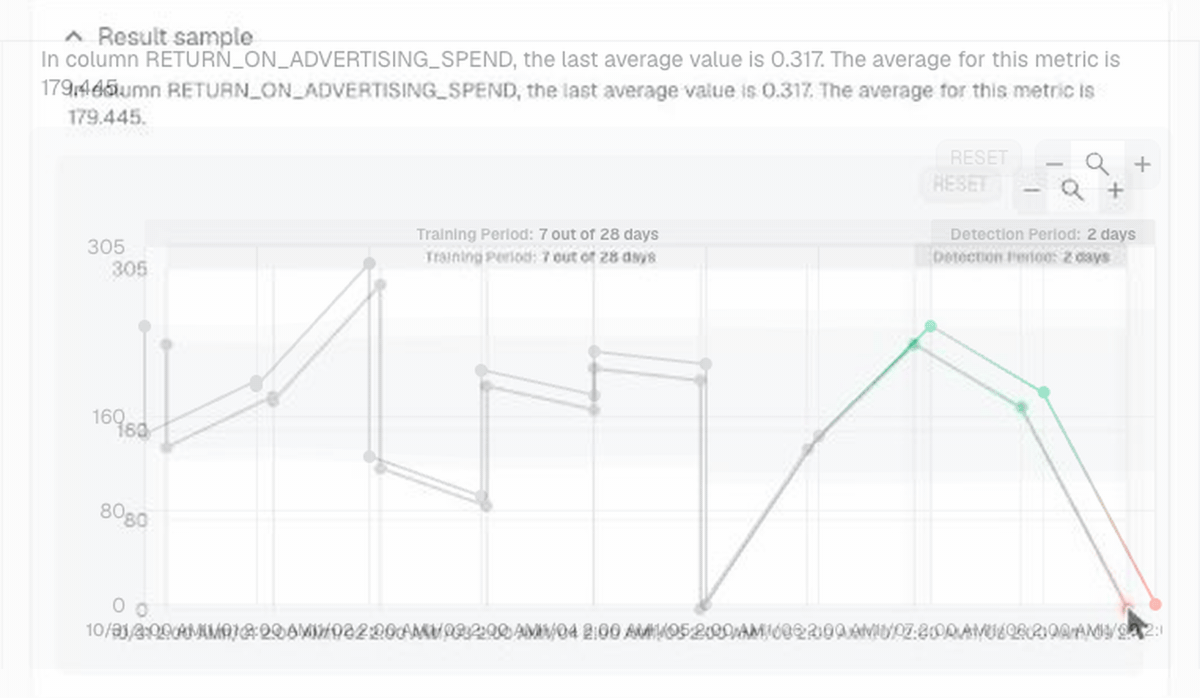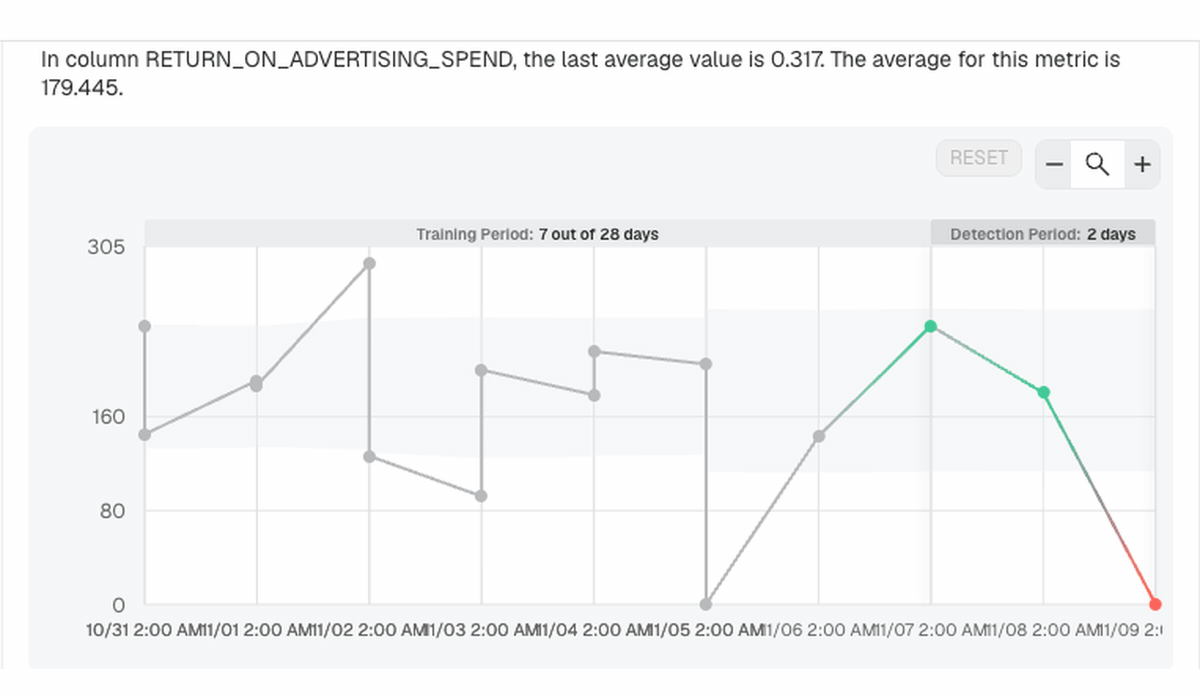
Surveiller la qualité des données de manière autonome
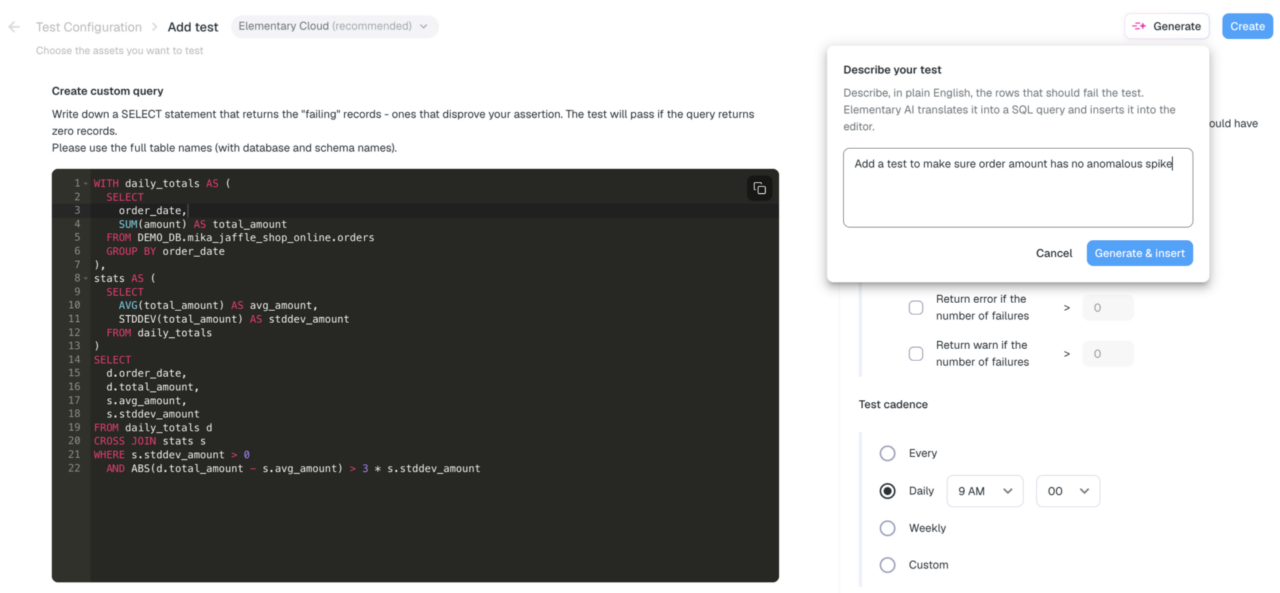
Détectez les données en retard, manquantes ou anormales grâce à des moniteurs d'apprentissage automatique prêts à l'emploi, ainsi qu'à des contrôles de qualité qui bloquent les modifications critiques avant qu'elles n'atteignent les tableaux de bord et les agents. Laissez les agents IA identifier les lacunes de couverture et recommander des tests que votre équipe pourra approuver.
Résoudre plus rapidement les problèmes liés aux données
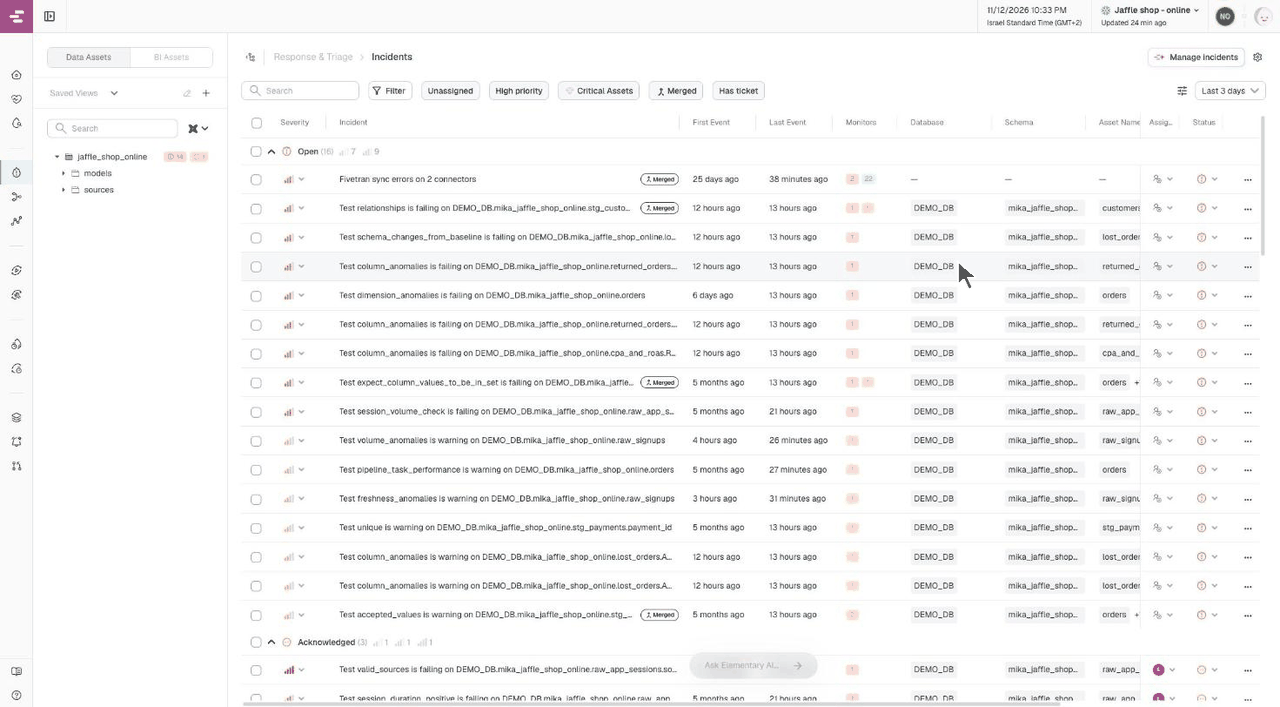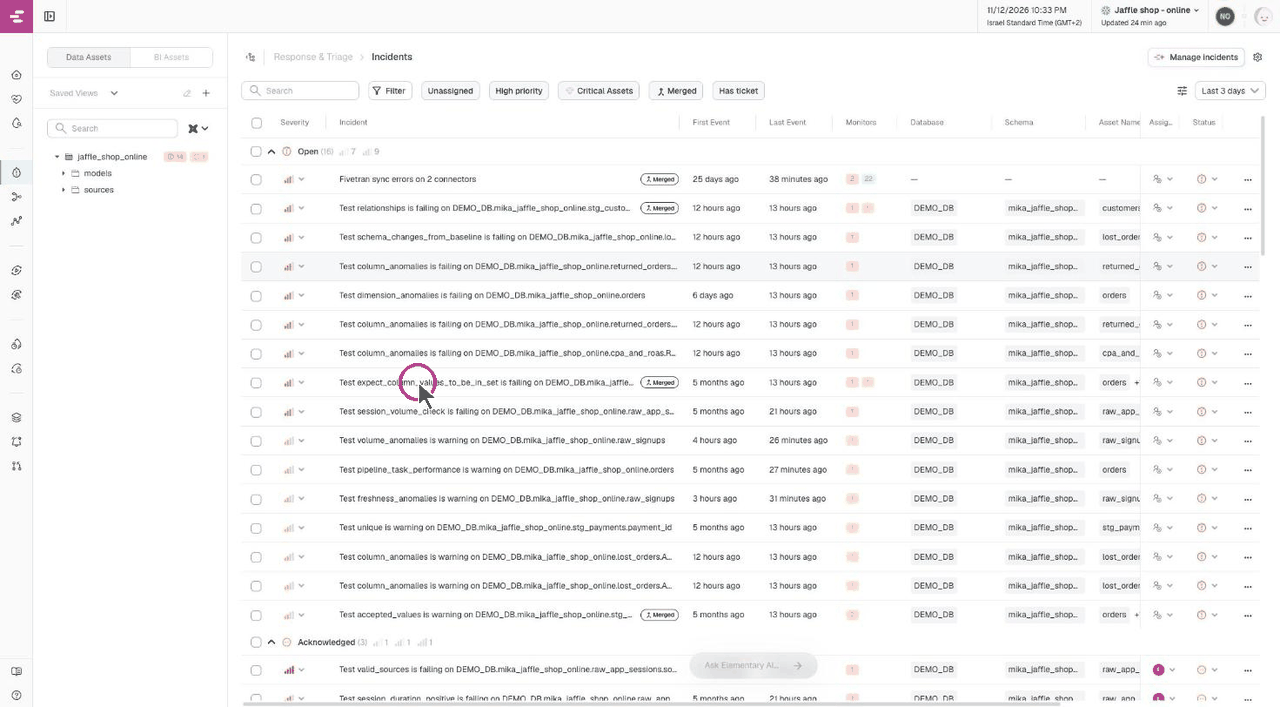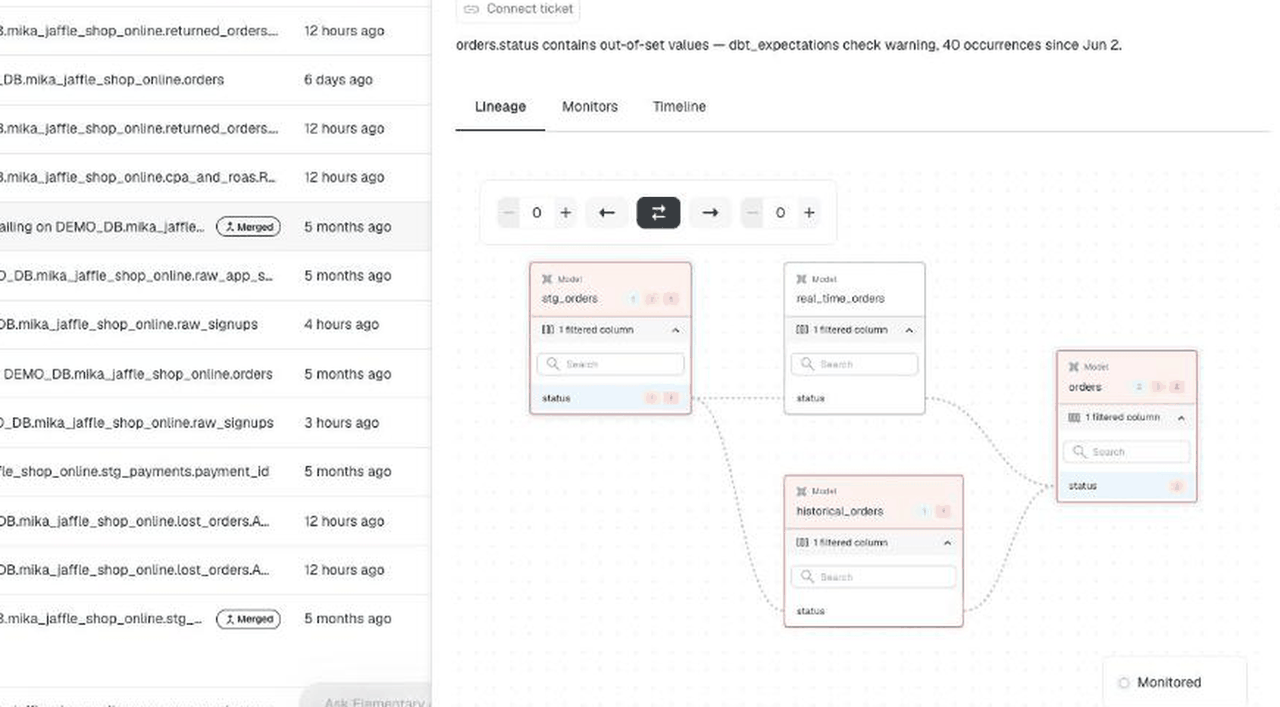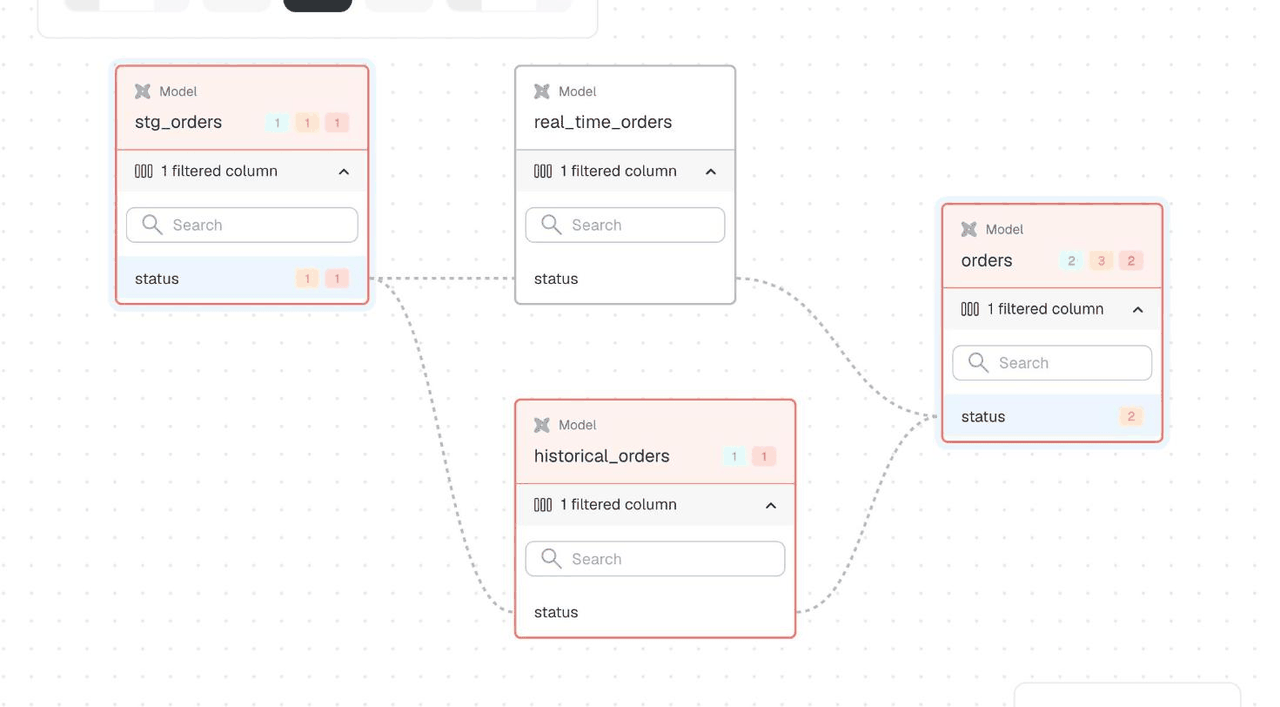
Regroupez les défaillances liées entre elles en un seul incident ayant une cause première unique, identifiez-en la source grâce à la traçabilité au niveau des colonnes et transmettez-le au responsable compétent. Laissez l'IA mener l'enquête, proposer une correction du code et ouvrir une pull request que votre équipe pourra examiner.
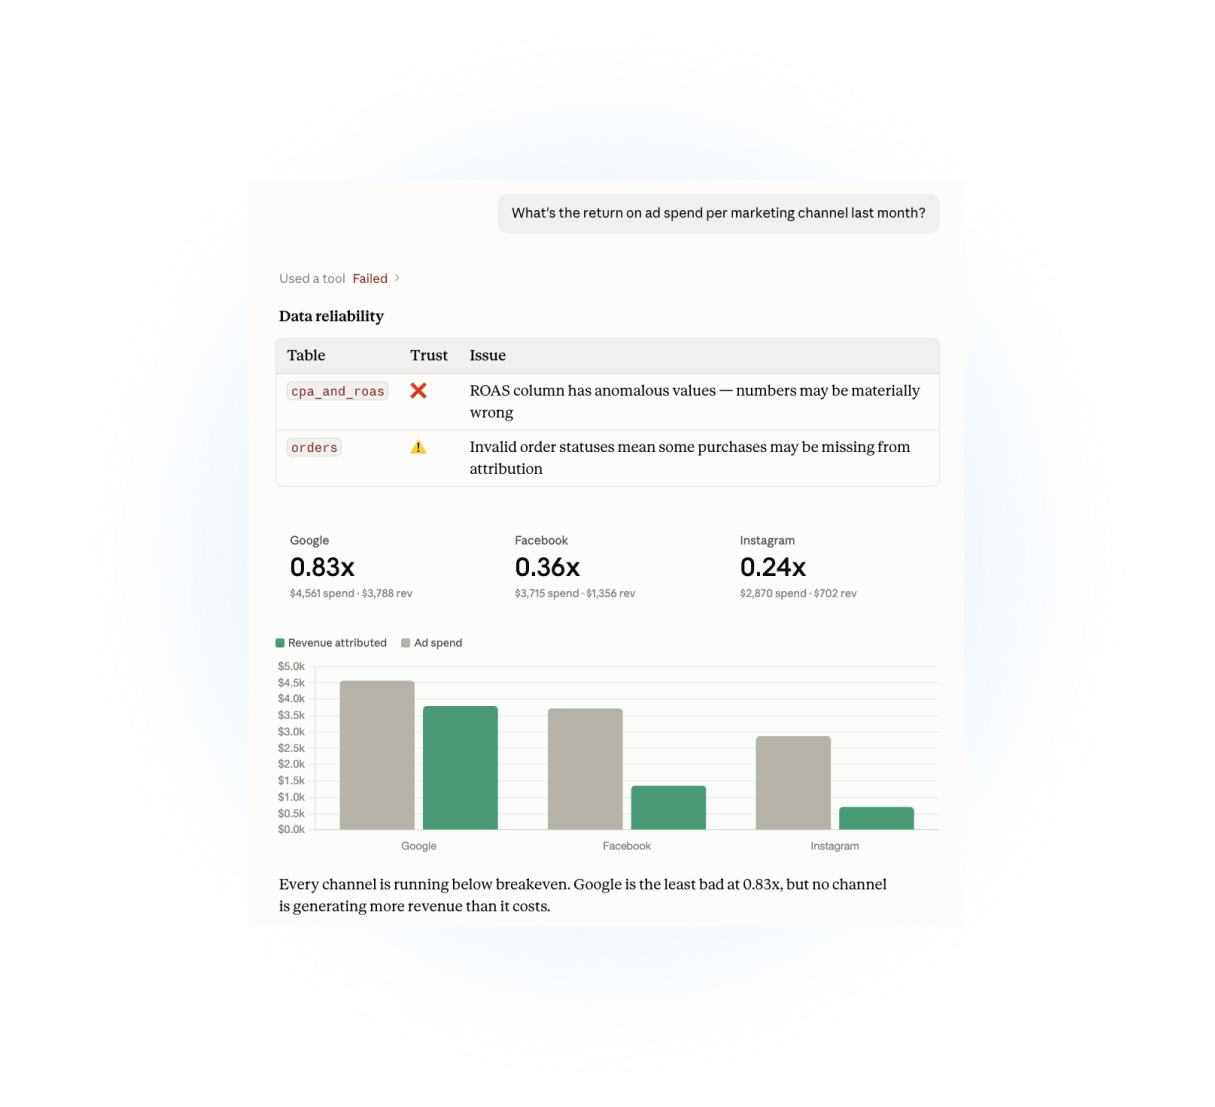
Indiquez aux agents quelles données sont fiables
Donnez à n'importe quel client d'MCP un accès en temps réel à l'historique, aux tests et aux incidents, afin que les agents et leurs utilisateurs puissent voir quand une réponse repose sur des données présentant des problèmes connus. Exécutez les agents sur un contexte pré-modélisé plutôt que de le recréer à chaque requête, ce qui permet de réduire le coût des jetons.
Rendre la fiabilité des données accessible à toutes les équipes
Les ingénieurs de données gèrent les tests sous forme de code et assurent le suivi des modifications et des validations. Les utilisateurs métier ajoutent des validations sans avoir à écrire de code. Les uns comme les autres peuvent vérifier l'intégrité des données et reçoivent des alertes en cas d'incidents affectant les données sur lesquelles ils s'appuient.
Caractéristiques de base des données
Détection des anomalies
Détectez les données en retard, manquantes ou anormales grâce à des moniteurs d'apprentissage automatique (ML) qui évaluent la fraîcheur, le volume et les métriques des colonnes, et qui sont prêts à l'emploi.
Couverture des tests d'IA
Identifiez les ressources non testées et obtenez des recommandations de tests en fonction de l'utilisation de vos données, que votre équipe devra ensuite valider.
Essais en cours de fabrication
Effectuez des vérifications au sein des pipelines dbt et Python afin que les problèmes soient détectés avant que les données ne soient transmises.
Intégrations de sources de données et de BI
Reliez les entrepôts de données, les outils de BI et les pipelines à l'échelle de l'ensemble de votre environnement de données afin d'obtenir une vue d'ensemble de l'état de vos données.
Traçabilité au niveau des colonnes
Suivre les chaînes de causes à travers les différentes transformations jusqu'à la cause première et à chaque élément affecté en aval.
Triage et résolution par IA
Identifiez de manière autonome la cause première du problème, évaluez son impact et proposez une solution sous forme de pull request que votre équipe pourra examiner.
Alertes et gestion des tickets
Créez un incident par problème et transmettez-le au responsable concerné sur Slack, PagerDuty et Jira.
MCP Serveur
Permettez à n'importe quel client d'MCP de consulter la traçabilité, les ressources et les incidents en cours, grâce au même contexte d'agent et à la même infrastructure.
Scores de santé des données
Évaluez la qualité des données par domaine, par équipe et par ressource. L'analyse de la qualité des données permet d'identifier les points à traiter en priorité.
Ce que disent nos clients

Ressources de données élémentaires
Questions fréquemment posées
L'observabilité des données permet de surveiller l'état de vos données et de vos pipelines. Elle détecte les données obsolètes, manquantes ou anormales, et aide les équipes à en identifier la cause et à y remédier avant que les utilisateurs en aval ne soient affectés.
Il utilise l'apprentissage automatique pour détecter les changements inattendus, tels qu'une baisse du nombre de lignes ou une table qui cesse de se mettre à jour. Elementary Data apprend à reconnaître ce qui constitue un comportement normal pour chaque ressource et signale rapidement tout écart.
Oui. Les utilisateurs professionnels peuvent créer des tests sans avoir à écrire de code, suivre les scores de santé et recevoir des alertes, tandis que les ingénieurs examinent les modifications via des pull requests.
La surveillance de base s'appuie sur les métadonnées, les journaux et les résultats de tests, sans accéder aux données brutes. Pour des vérifications plus approfondies et des analyses basées sur l'IA, Elementary Runtime exécute les tâches prises en charge au sein de votre environnement.
Elementary Data utilise un contexte d'agent et un harnais propriétaires, conçus pour la traçabilité et les métadonnées. Les agents démarrent avec le contexte dont ils ont besoin au lieu de le construire à partir de zéro ; ils utilisent donc moins de jetons qu'un modèle de contexte personnalisé sur des modèles Frontier génériques.
Elementary Data met à la disposition de n'importe quel outil d'IA les informations relatives à la traçabilité, aux tests, aux incidents et aux scores de santé via MCP. Avant d'agir, un agent peut vérifier si les données sont valides, à qui elles appartiennent et ce sur quoi elles ont une incidence.
Elementary associe la détection d'anomalies basée sur l'apprentissage automatique (ML) — portant sur l'actualité et le volume des données — à des vérifications exécutées au sein de vos pipelines, telles que les tests dbt ou Python. Les agents IA identifient les lacunes et étendent la couverture en fonction de l'utilisation de vos données.
dbt est facultatif. Si vous l'utilisez, Elementary s'intègre de manière native via son package dbt open source, et les modifications effectuées dans l'interface utilisateur sont synchronisées avec le code.
Elementary Data s'intègre nativement à dbt Core et dbt Cloud, se connecte à des entrepôts de données tels qu'Snowflake et Databricks, et étend la traçabilité au niveau des colonnes à des outils de BI comme Sigma et Looker. Il ouvre des pull requests sur GitHub et transmet des alertes vers Slack, Jira et bien d'autres encore.
Les défaillances liées sont regroupées en un seul incident avec une seule alerte, envoyée uniquement aux personnes responsables des ressources concernées ou abonnées à celles-ci. Les incidents sont résolus automatiquement lorsque les tests sont réussis.
Les agents fonctionnent selon un principe d'adhésion volontaire et sont hébergés en interne ; ainsi, aucune donnée n'est partagée avec des services externes. Chaque modification fait l'objet d'une pull request que votre équipe doit approuver.