

















Transfert de données conçu pour l'automatisation agentique
Boomi L'intégration de données permet de transférer les données en temps réel — un élément essentiel pour les charges de travail opérationnelles, analytiques et liées aux agents. Que ce soit sans code ou avec du code personnalisé, le déploiement s'effectue en quelques heures au lieu de plusieurs semaines, sans la charge de maintenance liée aux connecteurs point à point qui tombent en panne à chaque modification de l'API source.
Construire des connecteurs de données personnalisés
30X plus rapidement
Gagnez un temps précieux en matière d'ingénierie des données et créez des connecteurs de données personnalisés pour n'importe quelle source de données basée sur REST grâce à l'agent de connexion de données d'Boomi.

Comment ça marche ?
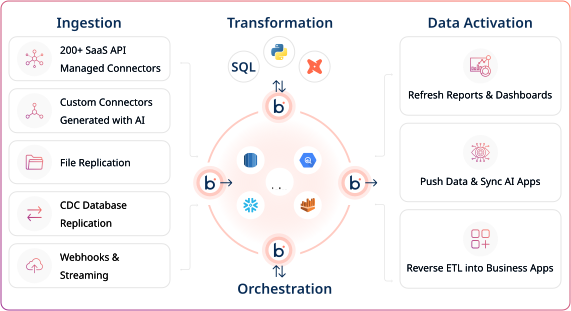
Boomi Data Integration fournit une solution unifiée pour l'ingestion, la transformation, l'orchestration, l'activation et les opérations de données. Mettez en place des pipelines de données fiables en quelques minutes, à partir de toutes vos applications et bases de données.
Connexion à n'importe quelle source de données sans code
Extrayez facilement des données de n'importe quelle application ou base de données. Chargez-les directement dans votre lac de données ou votre entrepôt de données en nuage via l'API gérée et la réplication CDC en quelques clics.
Transformer les données brutes en modèles de données commerciales
Transformez les données brutes en modèles de données d'entreprise avec SQL ou Python. Automatisez l'ensemble de votre processus d'intégration de données grâce à des flux de transformation avancés ou à nos kits de modèles de données prédéfinis.
L'orchestration des données en toute simplicité
Contrôlez votre flux de données du début à la fin. Gérez efficacement les dépendances entre et au sein de vos pipelines grâce à la logique conditionnelle, aux conteneurs, aux boucles et à la planification avancée.
Rendez toutes vos données opérationnelles grâce à l'ETL inversé
Poussez les données directement dans votre pile technologique avec l'ETL inversé. Enrichissez les données de votre CRM, envoyez des informations sur les données à Slack, déclenchez un rafraîchissement de Tableau, contrôlez n'importe quelle API de service.
Faites évoluer vos pipelines de données avec DataOps en mode natif
Gérez vos DataOps sans effort. Bénéficiez d'une vue claire sur l'ensemble de l'activité et de la consommation de vos pipelines. Ajoutez des pipelines sans aucun problème d'infrastructure. Déployez instantanément entre les environnements et revenez en arrière de manière transparente entre les versions.
Fonctionnalités d'intégration Boomi
Création et exécution de workflows assistées par l'IA grâce à « Boomi Companion » et « Boomi Orchestrate ».
Connexion à n'importe quelle source de données
Plus de 200 connecteurs de données natifs prêts à l'emploi ou des connecteurs personnalisés pour n'importe quelle source de données avec des capacités d'API et de webhook personnalisées.
Moteur d'orchestration puissant
Automatisez et orchestrez des flux de données complexes du début à la fin grâce à une logique avancée, des branchements, une logique conditionnelle, etc.
Couche de transformation robuste
Effectuer des transformations basées sur SQL dans la base de données ou en Python, en utilisant la boucle, la logique conditionnelle et la prise en charge de la création de dépendances.
API et interface de ligne de commande
Exécuter, éditer, déployer et gérer à distance des pipelines de données via CLI et convertir les pipelines de données en infrastructure as code (laC).
Prise en charge native de Python
Exécutez vos propres scripts Python dans le nuage en tant qu'étapes natives du pipeline de données sans aucun effort.
SaaS entièrement géré
Déployez de nouveaux pipelines en quelques minutes et évoluez automatiquement pour gérer n'importe quelle charge, tout en bénéficiant d'une sécurité de niveau entreprise et d'une maintenance nulle.
Activation des données
Transférez les données de votre entrepôt de données en nuage vers des applications tierces grâce à l'ETL inverse.
Kits de démarrage instantanés
Lancez des flux de travail avec des modèles de données complets en un clic - y compris une logique commerciale prédéfinie.
DataOps intégré
Faites évoluer vos pipelines en toute confiance grâce à des déploiements automatisés entre les environnements, au contrôle des versions et à la surveillance de la plateforme.
Boomi nommé « Exemplary » en Data Integration et Master Data Management
La puissance de la plateforme
Tirez le meilleur parti de votreEnterprise Platform Boomi .
Intégration transparente des applications
Faites circuler les données entre vos applications et automatisez les processus métier critiques.
Synchroniser les données entre les applications
Établir un service de gestion de données centralisé et sécurisé avec Boomi Data Hub pour une découverte et une gouvernance transparentes des données.
Gérer l'AI agentique
Construire des produits de données utilisés dans Boomi Agentstudio pour concevoir, gouverner et orchestrer tous les agents d'AI à l'échelle.
Étendre les capacités de gestion des API
Gérez facilement les règles de politique comme le cache et l'accès basé sur les rôles et fournissez une visibilité sur les mesures de performance de l'API avec un portail et un tableau de bord pour les développeurs d'API.
Ce que disent nos clients
Ressources sur l'intégration des données






Questions fréquemment posées
Boomi L'intégration des données relie n'importe quelle source à n'importe quelle destination grâce à des pipelines sans code et à la réplication en temps réel par capture des données modifiées (CDC), ce qui permet aux systèmes opérationnels, à l'infrastructure d'analyse et aux agents d'IA de fonctionner à partir de données à jour, plutôt que sur la base d'exportations par lots qui deviennent obsolètes en quelques heures.
L'ELT (Extract, Load, Transform) charge d'abord les données brutes dans leur destination, puis les transforme à cet endroit. Boomi permet de déployer des pipelines ELT automatisés en quelques minutes grâce à des centaines de connecteurs « no-code », avec la possibilité d'utiliser du code personnalisé lorsque cela s'avère nécessaire.
Boomi utilise la réplication CDC (Change Data Capture) pour synchroniser les modifications au fur et à mesure qu'elles surviennent, au lieu d'attendre les tâches batch, ce qui permet aux systèmes en aval et aux agents d'IA de toujours travailler à partir des données les plus récentes, et non d'un instantané datant de la veille.
L'agent Data Connector est une fonctionnalité d'IA spécialement conçue par Boomiqui permet de créer à la demande des connecteurs personnalisés pour toutes les sources basées sur REST à partir de la documentation des API. Vous n'êtes ainsi plus contraint d'attendre la feuille de route d'un fournisseur.
La pile de données moderne a entraîné une charge supplémentaire liée à la gestion d’une approche « best-of-breed », tandis que les outils ETL traditionnels sont trop complexes pour s’adapter au paradigme ELT moderne actuel dans le cloud. Boomipropose une approche de plateforme unifiée qui permet aux équipes chargées des données d’ingérer, de transformer, d’orchestrer et d’activer leurs données à partir d’une seule et même interface control plane. Offrant à la fois des approches « low-code » et de code personnalisé pour créer des pipelines ELT automatisés, Boomi Data Integration propose plus de 200 connecteurs natifs ainsi qu’un Data Connector Agent pour les sources personnalisées, permettant de connecter des données où qu’elles se trouvent.
Les pipelines, dont la mise en place et la maintenance prenaient auparavant plusieurs semaines, peuvent désormais être déployés en quelques heures grâce à des connecteurs « no-code » et à la réplication CDC automatisée.
Boomi transfère les données vers des entrepôts de données, des lacs de données, des applications opérationnelles et directement vers des agents d'IA. Une seule couche d'intégration alimente l'analyse, les opérations et l'IA agentique, et pas seulement les tableaux de bord de BI.
BoomiLes connecteurs de [nom] sont gérés et mis à jour de manière centralisée à mesure que les API sources évoluent, ce qui permet à vos pipelines de continuer à fonctionner sans aucune intervention manuelle — contrairement aux intégrations point à point fragiles, qui cessent de fonctionner dès que l’API source change.